Posts mit dem Label ebook werden angezeigt. Alle Posts anzeigen

Samstag, 29. März 2014

Silbentrennung für Ebooks

ISOIEC-9995-7-076--IEC-60417-6073--Symbol-for-Soft-Hyphen
Soft-Hyphen Keyboard Symbol
Quelle: Wikipedia, CC0
Ja, der Titel ist geklaut. Vor ca. zwei Wochen war ich wieder einmal auf den Chemnitzer Linuxtagen und bin dort auf den Vortrag von Georg Pfeiffer »Perfekte Silbentrennung in E-Books mit präreformatorischen Texten« gestoßen.

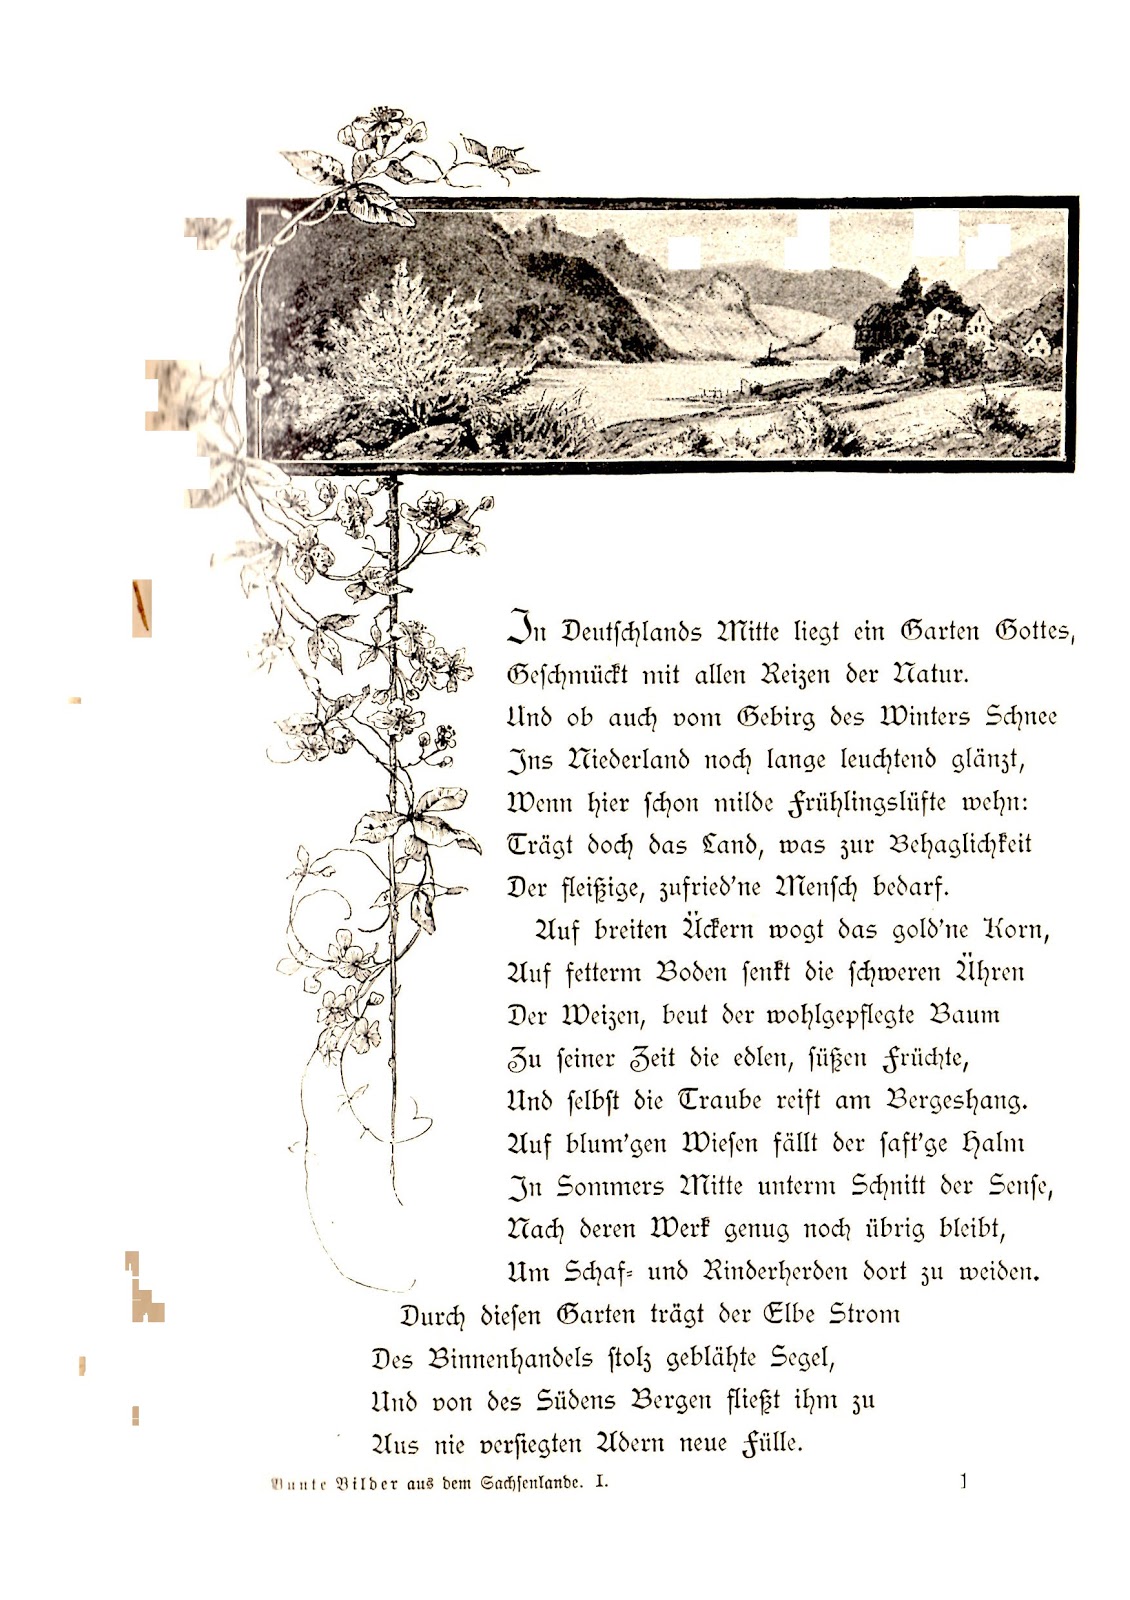
Da ich ja ua. die »Bunte Bilder aus dem Sachſenlande« als E-Book aufbereite, benötige ich für meine Texte ebenfalls eine "perfekte" Silbentrennung. Georg hat in seinem Vortrag auf das Projekt »Trennmuster« der TeX-Leute hingewiesen. Das hat mich neugierig gemacht.

Nach dem Herunterladen des Projektes (was sehr lange dauert, da die Wortlisten knapp 15MB groß sind) mittels

$> git clone git://repo.or.cz/wortliste.git

findet man die Trennmuster in den Dateien pre-1901 und wortliste. Die letztere ist für mich eher uninteressant, da diese nur Wörter nach den jeweiligen Rechtschreibreformen enthält. Die pre-1901 ist recht einfach aufgebaut, hier ein Auszug:

aber<mah-li-gen
ab<füh-re-ten
ab<ge<fer-ti-get
ab<ge<than
ab<ge<theilt
ab<hoh-len
ab<thei-len
ab<theil-ten
Ab<thei-lung
Ab<thei-lun-gen
…


Das Zeichen '<' bezeichnet die Trennung, falls es sich um eine Vorsilbe handelt. Das Zeichen '-' gibt eine normale Trennung an, das Zeichen '=' (im Beispiel nicht vorhanden) eine Trennung zwischen zusammengesetzten Worten.

Für ein Ebook sind mir diese unterschiedlichen Trennungen egal, so das ich, wie Georg, an all den Trennstellen ein Weiches Trennzeichen setzen möchte.  Unicode kennt solch ein Zeichen als Code U+00AD. Als HTML-Entität wäre es &shy;. Das weiche Trennzeichen erlaubt es, Trennanweisungen zu kodieren, für den Fall, daß das Anzeigeprogramm gezwungen ist, den Text umzubrechen. Es ist also nur an Zeilenumbrüchen als Trennzeichen zu erkennen und sonst im Text unsichtbar.

In meinem Perlscript zur Verarbeitung des Roh-Textes zu einem eigenen Asciidoc lese ich die Datei pre-1901 ein, es entsteht ein Hash %hyphens, der als Schlüssel das ungetrennte Wort verwendet und als Wert die getrennte Version mit weichen Trennzeichen. Dabei werden nicht die Feinheiten, die mit der Trennmuster-Datei möglich wäre unterschieden, sondern eine vereinfachte Variante kodiert.
Aus 'ab<thei-len' würde also der Schlüssel 'abtheilen' und die Trennvariante (hier mit '-' statt Unicode) 'ab-thei-len' als Wert entstehen.


 sub find_hyphens {
    my $filename="hints/pre-1901";
    open (my $fh, "<", "$filename");
    binmode $fh, ":utf8";
    while (<$fh>) {
        chomp;
        # replace '-' to &shy;
        s#([a-z])-$#$1\x{00ad}#g; # &shy; U+00AD
        my $hyphenized=$_; # simplifed hyphenized

        $hyphenized=~s/[<>=-]/\x{00ad}/g;
        my $orig=$_;
        $orig=~s/[<>=-]//g; # original, dehyphenized word
        $hyphens{$orig}=$hyphenized;
    }
    close $fh;
}

Im weiteren Programm bekomme ich die Textzeilen zeilenweise übergeben. Mit folgendem Snippet lese ich dann die Wörter und ersetze sie durch ihre weich-getrennte Version:
        # inject hyphens (for ebooks)
   foreach my $word (keys %hyphens) {
        my $hyphenized = $hyphens{$word};
        s#\b$word\b#$hyphenized#g;
   }
Voila!

Als Nebeneffekt bekommt das Trennzeichenprojekt meine Wortliste aus dem Buchprojekt. Auf alle Fälle war diese Erfahrung ein gutes Beispiel dafür, wie man sich in der Welt der Freien Software gegenseitig befruchten kann. Danke für die Idee an Georg!

Sonntag, 13. Januar 2013

Teil 8, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"

Der Prozess der Nachkorrektur der OCR-Texte des Buches "Bunte Bilder aus dem Sachsenlande" ist recht zeitaufwendig. Um besser Fehler zu finden, aber auch mal ein Zwischenergebnis zu haben, habe ich folgendes Bash-Script geschrieben, welches mir ein rudimentäres EPub-Dokument zusammenbaut:

# generates a rudimentary epub
NAME=/tmp/$1
DIR=$(echo $2|sed -e "s/\/$//g")
PAGES=$(ls $DIR)
mkdir -p $NAME
mkdir -p $NAME/$DIR
echo -n "application/epub+zip" >$NAME/mimetype
mkdir -p $NAME/META-INF
cat <<CONTAINER >$NAME/META-INF/container.xml
<?xml version="1.0" encoding="UTF-8"?>
  <container
    xmlns="urn:oasis:names:tc:opendocument:xmlns:container"
    version="1.0">
    <rootfiles>
      <rootfile
        full-path="$DIR/inhalt.opf"
        media-type="application/oebps-package+xml"/>
    </rootfiles>
  </container>
CONTAINER
cat <<OPF1 >$NAME/$DIR/inhalt.opf
<?xml version="1.0" encoding="UTF-8"?>
  <package
    xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    xmlns:dc="http://purl.org/dc/elements/1.1/"
    xmlns:opf="http://www.idpf.org/2007/opf"
    xmlns="http://www.idpf.org/2007/opf"
    version="2.0"
    unique-identifier="BookId">
    <metadata>
      <dc:language xsi:type="dcterms:RFC3066">de-DE</dc:language>
      <dc:title>Hello World</dc:title>
      <dc:identifier id="BookId">id_Hello_World</dc:identifier>
    </metadata>
    <manifest>
      <item id="ncx" href="inhalt.ncx" media-type="application/x-dtbncx+xml"/>
OPF1
for i in $PAGES; do
      cat <<OPF2 >>$NAME/$DIR/inhalt.opf
     <item id="Datei_$i" href="$i.xhtml" media-type="application/xhtml+xml"/>
OPF2
done
cat <<OPF3 >>$NAME/$DIR/inhalt.opf     
    </manifest>
    <spine toc="ncx">
OPF3
for i in $PAGES; do
cat <<OPF4 >>$NAME/$DIR/inhalt.opf
      <itemref idref="Datei_$i"/>
OPF4
done
cat <<OPF5 >>$NAME/$DIR/inhalt.opf
    </spine>
  </package>
OPF5
cat <<NCX1 >$NAME/$DIR/inhalt.ncx
<?xml version="1.0" encoding="UTF-8"?>
  <!DOCTYPE ncx
    PUBLIC "-//NISO//DTD ncx 2005-1//EN" "http://www.daisy.org/z3986/2005/ncx-2005-1.dtd">
  <ncx
    xmlns="http://www.daisy.org/z3986/2005/ncx/"
    version="2005-1"
    xml:lang="de-DE">
    <head>
      <meta name="dc:Title" content="Hello World"/>
      <meta name="dtb:uid" content="id_Hello_World"/>
    </head>
    <docTitle>
      <text>Hello World</text>
    </docTitle>
    <navMap>
NCX1
for i in $PAGES; do
cat <<NCXPAGES >>$NAME/$DIR/inhalt.ncx
      <navPoint playOrder="1" id="id_$i">
        <navLabel>
          <text>$i</text>
        </navLabel>
        <content src="$i.xhtml"/>
      </navPoint>
NCXPAGES
done
cat <<NCX2 >>$NAME/$DIR/inhalt.ncx
    </navMap>
  </ncx>
NCX2
for i in $PAGES; do
cat <<XHTML1 >$NAME/$DIR/$i.xhtml
<?xml version="1.0" encoding="UTF-8"?>
  <!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.1//EN"
     "http://www.w3.org/TR/xhtml11/DTD/xhtml11.dtd">
  <html xmlns="http://www.w3.org/1999/xhtml">
    <head>
      <meta http-equiv="Content-Type" content="text/html; charset=UTF-8"/>
      <link rel="schema.DC" href="http://purl.org/dc/elements/1.1/"/>
      <title>$i</title>
      <meta name="DC.identifier" content="id_$i"/>
    </head>
    <body>
XHTML1
cat $DIR/$i | sed -e "s/&/&amp;/g" -e "s/</&lt;/g" -e "s/>/&gt;/g" >>$NAME/$DIR/$i.xhtml
cat <<XHTML2 >>$NAME/$DIR/$i.xhtml
    </body>
  </html>
XHTML2
done
pushd $NAME
zip -Z store -X $NAME.epub mimetype
zip -9 -X -r $NAME.epub META-INF/
zip -9 -X -r $NAME.epub $DIR/
popd
Das Script wird mit 2 Parametern aufgerufen, der erste gibt den Namen (nicht Pfad) des Zieldokumentes an, der zweite das Verzeichnis mit den OCR-Dateien. Es erzeugt dann das Dokument im Verzeichnis /tmp als $NAME.epub

Das Script enthält noch kein Feintuning und die Kapitel entsprechen den Seitenzahlen. Um das erzeugte Epub-Dokument auf Korrektheit zu testen benutze ich den Validator  EPubCheck Version 3.0. Dieser prüft sehr genau und es hat eine Weile gedauert, bis das Script ein nahezu fehlerfreies Dokument erzeugt hat.  Zum Prüfen des erzeugten EPUB einfach folgenden Aufruf verwenden: java -jar epubcheck-x.x.x.jar file.epub

Einen Zwischenstand des Buches gibt es hier: https://www.dropbox.com/s/sf9j53ovg7qku0p/Bunte_Bilder_2013-01-13.epub

Freitag, 28. Dezember 2012

Auf der Stammburg der Wettiner

Der folgende Text ist übernommen aus »Bunte Bilder aus dem Sachsenlande«, welches ich nach und nach als Digitalisat und EBook neu zugänglich machen will. Er umfasst dort die Seiten 3 bis 8.


Der nachfolgende Beitrag stammt von Franz Woenig, nach de.metapedia.org, als Lehrer und Schriftsteller vor allem in Lokalzeitungen in und um Leipzig unterwegs. Er wurde am 28. Februar 1851 in Breitenhagen bei Barby an der Elbe geboren und ist am 16. Februar 1899 in Leipzig verstorben.


Auf der Stammburg der Wettiner


»Dort ſind ſchon die Schachtberge, und drüben ſehen Sie den Schweizerling.
Auf ſeine bewaldete Höhe wandert das junge Volk Wettins an Sonn- und Feſt-
tagen gern hinauf; denn es iſt gar ſchön da droben. Wenn wir die beiden Wind-
mühlen im Rücken haben, ſehen wir Wettin drunten im Thale.«

So berichtete der biedere Wettiner Ackerbürger, indem er angeſichts der
beiden Windmühlen ſtehen blieb und ſeinen langſchößigen Sonntagsrock wieder
anzog. Seine kugelrunde, geſprächige Ehehälfte, mit der er von einer kleinen Reiſe
zurückkehrte, klappte hierauf den Regenſchirm zuſammen, den ſie in Ermangelung
eines Sonnenſchirms als Schutz gegen die brennenden Strahlen der Frühlings-
ſonne aufgeſpannt hatte. Der Tag war heiß, und die Luft war ſtill.

Der holperige Feldweg, auf dem wir ein und eine halbe Stunde lang von
der Station Nauendorf an durch unabſehbare Feldpläne rüſtig vorwärts geſchritten
waren, wurde allmählich ſteinig, und hier und dort traten bereits die breiten
verwetterten Schichten des rötlichen Porphyrs zu Tage.

»Unſer Städtchen iſt ſteinreich und doch arm,« ſagte mein Begleiter, als er
fah, daß ich einige Porphyrſtücke aufhob und ſie prüfend betrachtete. »Freilich,«
fuhr er fort, »müſſen wir dem Himmel auch für dieſen Reichtum danken; denn
außer in den Schächten und Cichoriendarren und auf den Schiffen des Saal-
stromes ſind viele Menſchen in den Steinbrüchen beſchäftigt und haben da ihr
kümmerliches Brot. Doch wir ſind dem Ziele nahe, – da drunten liegt Wettin!«

Mit einem Schlage hatte ſich die Scenerie verändert. Von der Höhe eines
Bergkammes blickte ich hinunter in das Thal. Meine Blicke ſchweiften über die
altersgrauen Ziegeldächer des kleinen Bergſtädtchens hin, deſſen Häuschen dicht
gedrängt wie Schwalbenneſter jenſeits am Berghange klebten und ſich bis auf den
Rücken desſelben hinaufzogen. Eins wie das andere gebaut, harmonierten ſie
prächtig mit dem Felsgeſtein, auf dem ſie ſtanden. Nur einige hoben ſich durch
lebhaftern Anſtrich aus dem Häuſermeer heraus, das die Türme der Kirche, des
Rathauſes und der Burg überragten. Der Tag war ſtill und heiter und bot
eine weite Fernſicht. Hier und dort glänzte das rötliche Geſtein der ſchroffen
Felswände. Drüben im Blauen ſangen die Lerchen. Drunten zur Linken blinkte
und blitzte das ſilberne, vielfach gewundene Band des Saalſtromes, der aus ſeinen
Ufern getreten war und das Wieſengelände überſchwemmt hatte. Und nun leuchtete
und flimmerte es in dem wäſſerigen Grün der Auen und zwiſchen den knoſpenden
Bäumen und Büſchen kleiner Strominſelchen, als habe die Sonne einen Demant-
regen über ſie ausgeſchüttet.

So, wie es da vor mir lag, und nicht anders hatte ich mir das alte Berg-
ſtädtchen Wettin gedacht: im Äußern unberührt vom Strome der Neuzeit, ein
Denkmal ferner ſchöner Vergangenheit, ein würdiger Zeuge deutſchen Fürſtenruhms
und deutſcher Fürſtengröße! Und voll Freude und Stolz hing mein Blick an den
hohen Mauern und an den Turmzinnen der alten Burg, die ſich im Süden auf
einer ſcharf vorgeſtreckten Felszunge trotzig und kühn erhebt und die Dächer der
Stadt weit überragt. Dieſer ehrwürdige, ſchlichte, feſte Bau, der mit dem Fels
verwachſen ſcheint, der den Stürmen und Wettern faſt eines Jahrtauſends getrotzt
hat, iſt das ſchönſte Symbol des edlen ruhmreichen Fürſtenhauſes der Wettiner.
Nicht der romantiſche Hauch der Sage umwebt die alten Mauern — unſer Volk
weiß nichts Wunderſames von dieſer Burg zu ſingen und zu ſagen —, wohl aber
der Geiſt hoher, tapferer und großherziger Ahnen und der Geiſt einer glorreichen
achthundertjährigen Vergangenheit! Sie ſchützen die Wiege unſeres teueren
Herrſchergeſchlechtes und werden auch das Haus Wettin auf ſtolzer, ſonniger Höhe
erhalten, wenn Bau und Fels längſt in Trümmer geſunken ſind! . . .

»Schade um unſere ſchöne alte Burg,« plauderte mein Reiſegefährte, als
wir auf ſteilem, ſchmalem Pfade abwärts ſtiegen und durch die engen, gewundenen
Gäßchen des Städtchens dem alten Rathauſe zuwanderten. »Wir Wettiner wiſſen
wohl, welche Bedeutung ſie hat,« fuhr er fort, »und wir würden uns freuen,
wenn unſer junger Kaiſer die Burg Ihrem König Albert ſchenkte. Die Schaf-
herden, welche in den Räumen kampieren, könnte man wohl noch auf dem Amts-
hofe unterbringen und auch die Kornböden dorthin verlegen; die Bierbrauerei,
ſeither in dem Flügel nach der Stadtſeite zu gelegen, hat man ſo wie ſo ſeit Neu-
jahr eingeſtellt. Arme alte Invaliden müßten da hinein, die einſt mit Gott für
König und Vaterland ihr Blut und ihre Geſundheit gelaſſen haben; dann würde
die Burg ihren Zweck erfüllen.« Ich konnte ihm aus vollem Herzen beiſtimmen.

Im kühlen Rathauskeller zur Seite des kleinen abſchüſſigen Marktplatzes er-
holte ich mich nach der ermüdenden Fußwanderung und forſchte bei Wirt und
Gäſten nach der Geſchichte der Burg und Stadt Wettin. Die Leutchen wußten
mir ſehr wenig zu erzählen. Das chroniſtiſche Material iſt bei dem großen
Brande im Jahre 1666 verloren gegangen und das Rathaus von Grund auf neu
gebaut worden.

Nach einigen alten Chroniſten iſt der römiſche Feldherr Claudius Drufus
Nero als Gründer anzuſehen, der auf  ſeinen Heereszügen in den Jahren l2–9
v. Chr. in Germanien bis in die Saalgegend gekommen und außer einem feſten
Kaſtell, der jetzigen Burg Wettin, auch auf dem Lauterberge (Petersberg bei Halle)
einen Tempel zu Ehren des Mars und der Bellona errichtet haben ſoll. Ähn-
lichkeiten des Namens haben andere verleitet, den Herzog Wittekind als Ahnherrn
des Hauſes Wettin und Erbauer des alten Stammſitzes zu nennen; doch iſt
längſt ſicher nachgewieſen, daß die Beſitztümer dieſes Geſchlechts in Weſtfalen
lagen, und daß die Wettiner aus Nordſchwaben ſtammen.
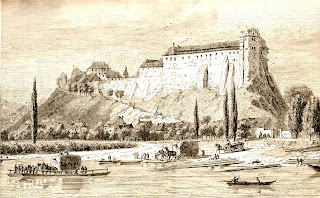
Burg Wettin


Und wird auch der Urſprung der Burg in Dunkel gehüllt bleiben: das alte
Bauwerk redet lauter als alle Chroniken und verweiſt uns in die erſten Jahr-
hunderte unſerer Zeitrechnung.

Wettin (Wittin) iſt ein wendiſches oder ſlaviſches Wort. In den älteſten Chro-
niken wird die Stadt Vidin genannt und bereits im Jahre 960 n. Chr. als civitas
(Stadt), im pago (Diſtrikt) Nuzini oder Buzini gelegen, aufgeſührt. Aus dieſem
Gau ſchenkte Kaiſer Otto I. der Kirche zu Magdeburg den Zehnten der Einkünfte.

In alter Zeit hatte die Grafſchaft Wettin einen bedeutenden Umfang. Außer
dem eigentlichen Burglehn gehörte der Petersberg mit allen ſeinen Gütern, das
Schloß Kroſigk, Löbejün mit ſeinen Dörfern und vielleicht auch die Stadt Halle
zu dieſem Diſtrikt. Die ſtark befeſtigte Burg Wettin galt als eins der beſten und
ſicherſten Bollwerke, die man im Elb- und Saalgau errichtet hatte, um dem energiſchen
Vordringen der kriegeriſchen, Ackerbau treibenden Sorben-Wenden Einhalt zu ge-
bieten. Das Wappen der Grafen zu Wettin zeigte einen roten Löwen in ſilbernem
Felde. Auf dem Wappenhelme ſtieg aus ſilbernem Grund ein roter Adler mit
ſchwarzen Flügeln auf. Die Flügel waren mit goldenen Herzchen oder kleinen
Kleeblättern beſetzt.

Der erſte bekannte Graf von Wettin iſt Dietrich I., der den Kaiſer Otto II. auf
ſeinem Zuge nach Italien begleitete und 982 bei Baſentello fiel. Von ſeinen Söhnen
erbte Dedi I. Wettin und Friedrich die Grafſchaft Eilenburg. Friedrich ſtarb 1017
kinderlos, und nun vereinigte Dedis Sohn, Dietrich II., der 1009 ſeinem Vater
gefolgt war, Eilenburg wieder mit Wettin. Dietrich II. ſtarb 1034 und hinter-
ließ ſechs Söhne, von denen Thimo, 1090 Markgraf von Meißen, ſich zuerſt nach
ſeiner Burg Graf von Wettin nannte. Als ſein Sohn und Nachfolger Dedi III.
1124 auf ſeiner Heimfahrt aus dem gelobten Lande ſtarb, fiel Wettin an ſeinen
Bruder, den Markgrafen Konrad den Großen von Meißen, und iſt danach längere
Zeit der Mark Meißen als erblicher Beſitz verblieben.

1288 kamen Wettin und Salzmünde durch Schenkung zum Erzſtift Magde-
burg, und ſo ging dieſer ſchöne Beſitz dem ſächſiſchen Fürſtenhauſe ſür immer ver-
loren. Gegenwärtig iſt das ehemalige Burgamt eine königlich preußiſche Domäne.

Der Prinz Louis Ferdinand von Preußen, welcher am 10. Oktober 1806
in dem unglücklichen Gefecht bei Saalfeld fiel, weilte am Anfange dieſes Jahr-
hunderts oft und gern auf der alten Burg. Von ſeinem leutſeligen Weſen und
ſeinen luſtigen Streichen wiſſen die lieben Wettiner noch heute zu erzählen.

Als ich in den Nachmittagsſtunden die Burg beſuchte, führte mich der In-
ſpektor des Amtsgutes auch in ein leeres Zimmer. Den einzigen Schmuck des-
ſelben bildeten zwei Niſchen, deren Bogen einfacher Rokoko-Ornamentenſchmuck
zierte. Von den Fenſtern des kleinen Gemachs aus, das ſich im linken Burg-
flügel befindet, genoß ich eine herrliche Ausſicht auf die alte Stadt. Dies Prinzen-
zimmer iſt wohl noch der einzige bewohnbare Raum in der Burg; denn außer der
Wohnung des Aufſehers und dem Betſaale für die kleine reformierte Gemeinde des
Städtchens dienen alle übrigen landwirtſchaftlichen Zwecken.

Von ſchönen Aufgängen, Galerien, Eiſengeländern mit phantaſtiſcher Orna-
mentik und glänzenden Meſſingknäufen, geräumigen Hallen mit Kreuzbögen und
Säulen iſt auf der Burg nichts mehr zu finden. Die dicken Mauern ſind abge-
tragen, und von dem runden, ſtumpfen Turm inmitten des Hofes iſt die Grund-
mauer nur noch im Steinpflaſter bezeichnet. Der Turm von den Burgleuten »die
letzte Retirade« genannt, weil man ihn bei harten Kämpfen als letzten Zufluchts-
ort benutzte, iſt bereits 1697 beſeitigt worden. Die Wallgräben ſind in Gärten
umgewandelt, und durch die frühere Ausfallspforte tritt man jetzt auf eine Terraſſe,
welche eine ſchöne Ausſicht gewährt. Iſt auch der Geſamtcharakter des alten Bau-
werkes erhalten geblieben, ſo hat es doch im einzelnen mancherlei Veränderungen
erfahren. So z. B. ſind die Rokokoverzierungen an den Giebeln des Turmes
neueren Datums, die Sandſteinzieraten ſind verſchwundem und das Dach hatte
früher jedenfalls eine bedeutendere Höhe als jetzt. Der Ritterſaal, gegenwärtig
durch einen Boden in zwei Geſchoſſe geteilt, dient zur Aufnahme von Ackergerät und
beherbergt den Segen der Felder: große Lager von Weizen und Kartoffeln. Die
Wandgemälde des Saales hat man in frommer Einfalt mit Kalk übertüncht. Hier
und dort treten noch Überreſte von Kriegs- und Jagdſcenen hervor. Drunten im
Burgverließ, wo an der Wand als Symbol ſeiner Beſtimmung eine Hand mit
einer Keule und ein Kopf in Stein eingehauen ſichtbar ſind, breitet man Schafwolle
zum Trocknen aus, und im oberen Gemach des Turmes, in dem einſt der Burg-
wart hauſte, niſten ſriedlich die Tauben.

Lange ſtand ich droben im Turmzimmer an dem geöffneten Fenſter und
weidete Herz und Sinn an den tauſend Schönheiten der reizenden Landſchaft, die
ſich vor meinen Blicken auſthat. Drunten im blinkenden Fluſſe ſpiegelten ſich die
braunen Dächer und grauen Mauern langer Häuſerzeilen, und darüber hin fiel
das Bild der hohen, ſteilen Porphyrfelſen. Tiefgehende Kähne und Holzflöße
glitten ſtill ſtromabwärts. In dem braun und grün ſchimmernden Baumgezweig
des Inſelwäldchens, der Burg gegenüber, hatten ſich Schwärme von Raben und
Krähen niedergelaſſen und flickten eifrig an den zahlreichen Reiſigneſtern. Ihr
Gekrächze und Geſchrei übertönte das Klirren der Stromkette, an der die Fähre
von einem Ufer an das andere ſchwebte. Jenſeits des Fluſſes verlor ſich der
Blick in einem fruchtbaren Hügellande mit braunen Ackerplänen und ſaftig grünen
Saalfeldern.

Ein mit Akazienbäumen bepflanzter Weg führt von einer ſchmalen Mauer-
pforte aus an dem Burgberg entlang in das Saalthal hinab. Das geklüftete
Gestein des Burgfelſens hatte ſich bereits mit Frühlingsgrün bekleidet. Das un-
durchdringliche Rutengewirr des Teufelszwirns – in uralter Zeit wohl als Schutz-
wehr angepflanzt — wetteiferte mit Hopfengerank und knorrigen Fliederſträuchern.
Hier und da hatte auch der Epheu mit ſeinem dichten Netze die Mauer überſponnen.
Eins der kleinen Fenſter, die droben in der dicken Burgmauer in geringen Zwiſchen-
räumen angebracht ſind, war geöffnet. Auf dem Geſims prangte ein Flor blühender
Topfgewächſe, und das Fenſter war innen von weißen Gardinen umrahmt.

Mir kam der Wunſch meines biederen Reiſegefährten wieder in den Sinn
und ich ſah im Geiſte droben auf der Turmzinne das deutſche und ſächſiſche Banner
wehen ... all die kleinen, dunklen Fenſter des Burgflügels waren durch Gar-
dinenſchmuck freundlich erhellt, und über einen niedlichen Wald von Geranium und
Myrte ſchauten mit zufriedenen Blicken deutſche Invaliden in das Saalthal her-
nieder.

Franz Woenig.


Donnerstag, 13. Dezember 2012

Teil 6, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"

OCR Verbesserung mit unicharambigs


Mit der Erstellung einer Datei, hier deu-frak.unicharambigs gibt man Tesseract3 Hinweise, welche Zeichen durch welche ersetzt werden können oder sollten.

Hier der Inhalt meiner deu-frak.unicharambigs:

v1
1    B    1    V    0
1    c    1    e    0
1    e    1    c    0
1    f    1    ſ    0
1    ſ    1    f    0
1    V    1    B    0
1    m     2    i n    0
2    ( )    1    0    0
2    - —    1    —    1
2    , ,    1    »    1
2    — -    1    —    1
2    — —    1    —    1
2    1 n    1    m    0
2    - 3    1    s    0
2    - H    1    H    0
2    . H    1    H    0
2    - I    1    s    0
2    i h    2    c h    0
2    i i    1    ä    0
2    i i    1    n    0
2    i i    1    ü    0
2    i n    1    m    0
2    i v    1    w    0
2    l 1    1    U    0
2    l )    1    h    0
2    l l    1    U    0
2    n 1    1    m    0
2    n i    1    m    0
2    n i    1    w    0
2    r i    1    n    0
2    s -    1    s    0
2    t )    1    y    0
2    t i    1    n    0
2    t i    1    ü    0
2    t v    1    w    1
2    z n    2    z u    1
2    m i    2    u n    0
2    m n    2    u m    0
3    1 1 )    1    W    0
3    a n ſ    3    a u f    1
3    ä n ſ    3    ä u ſ    1
3    i i i    1    m    1
3    i i ſ    2    n ſ    1
3    i i ß    2    ü ß    1
3    n i a    2    m a    1
3    n n n    2    m m    0
3    ſ e h    3    ſ c h    0
3    ſ r e    3    f r e    0
3    t m n    3    t u m    0
3    C i n    3    E i n    0
3    i i c    2    ü c    1
3    t n d    3    t u d    1
3    u n n    2    m m    0
3    n n r    3    n u r    1
3    n n d    3    u n d    1
3    b n r    3    b u r    1
3    n u e    3    n n e    1
3    o l ſ    3    o l f    1
3    n m n    3    u n m    0
3    n ſ ſ    3    u f f    0
Die erste Spalte gibt an, wieviel Zeichen aus Original mit wievielen Zeichen ersetzt werden sollen.

Diese Zeile zum Beispiel:

3    i i c    2    ü c    1

gibt Tesseract die Anweisung, Teilstrings "iic" durch "üc" zu ersetzen. 


Erste Ergebnisse


Nach der OCR Erkennung habe ich jetzt im txt-Verzeichnis zu jedem Bild meine Textdateien, die ich nun nach und nach korrigiere. Hier als Ausschnitt die Seite 6 des Buches:
An den Leſer.

Das vorlieqende zweibändige Werk »Bunte Bilder aus dem
Sachſenlande« verſolgt einen doppelten Zweck.

Zunächſt iſt es dazu beſtimmt, Großen und Kleinen, Alten und Jungen
Kunde zu bringen von Land und Leuten, Kunde vom Leben und Treiben,
Singen und Sagen der Bewohner der verſchiedeneir Gegenden unſeres
engeren Vaterlandes. Mit der genaueren Kenntnis der Heimat aber ſoll es
ein lebhaftes Intereſſe ſür die Entwickelung derſelben und ſür ihre Eigen-
artigkeiten und Schönheiten vermitteln und ſo eine Heimatsliebe erwecken und
pflegen, die, wenn ſie ſich frei hält von Engherzigkeit und Überſchätzung
die schönſte Eigenſchaſt eines Staatsbürgers und die beſte Grundlage des
wahren, qeſunden Patriotismus iſt, der unſerem deutſchen Volke ſo not thut.

Daneben will das Buch aber auch darauf hinwirken, daß das Band
der Liebe, welches das Herrſcherhaus ſeit mehr denn 800 Jahren mit Land
und Volk verknüpft, ein immer innigeres und feſteres werde. An den
verſchiedenſten Stellen nimmt es daher Bezug auf die Geſchichte des er-
lauchten Hauses Wettin und auf den Einſluß, den die Herrſcher desſelben
auf das Gedeihen und Blühen des Sachſenlandes und auſ das Wohl des
Sachſenvolkes ausgeübt haben.

Die zahlreichen Artikel ſind in der Hauptſache geographiſcher und ge-
ſchichtlicher Natur; und da man ein Volk in ſeiner Eigenart nicht zum ge-
ringſten auch aus Sitte, Sang und Sage kennen lernt, ſo iſt anch dieſe
Seite des Volkslebens nichts unberückſichtigt geblieben.

Die Beiträge ſür das Buch ſind gelieſert worden von Lehrern und
Freunden der Jugend aus den verſchiedenſten Landesteilen. Einige dieſer
Beiträge erſcheinen im Gewande der Wiſſenſchaftlichkeit und ſind die Frucht
eingehender Quellenſtudien und ſachmänniſcher Einſicht, andere ſind in Form
und Inhalt mehr der Auffaſſungskraft des ſchlichten Mannes angepaßt;
einige ſind mehr belehrend, andere mehr unterhaltend, noch andere ſind

Sonntag, 9. Dezember 2012

Teil 5, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"


Update

Ergänzt um Wörterbucherzeugung und Häufigkeitsliste. Korrektur Fehler OCR-Text (falsche Datei erwischt).

Seitenweises Zeichenerfassen

Wie im letzten Artikel beschrieben, habe ich mir zur Verbesserung der Erkennungsgenauigkeit von Tesseract 3 Paare von TIFF-Dateien und Box-Dateien erzeugt, um die Zuordnung von Blobs zu den Zeichen im UTF-8 Format mit Hilfe von jTessBoxEditor festzulegen.

Ich hatte dazu 5 Seiten aus dem Originalscan ausgewählt, zwei davon aus dem Inhaltsverzeichnis, um auch Ziffern zu erfassen.

Diese Zuordnung hat relativ lange gedauert, da ich pro Seite ca. 2500 Zeichen editieren mußte.

Hartes Training

Das Training von Tesseract besteht aus mehreren Schritten. Wichtig ist die Erzeugung der font_properties Datei, die angibt, daß der Font gebrochen ist, sprich als Frakturschrift daherkommt. Dazu wird folgende Zeile eingetragen:

frak2 0 0 0 0 1

Ebenfalls wichtig sind zwei Dinge, erstens eine Wortliste, die auch Besonderheiten, wie das lange S korrekt enthalten sollte, zweitens ein Häufigkeitsliste, die angibt, welche Wörter, wie häufig vorkommen. Wenn man hier keine Arbeit reinstecken möchte, kann man die Dateien vom deu-frak-Paket verwenden (ist bei Tesseract dabei), die aber keine Unterstützung für langes S beinhaltet.

Mein Weg war daher folgender. Aus den Box-Dateien habe ich die Wörter extrahiert und daraus meine Wortliste gebaut.

Dazu habe ich mit folgendem Aufruf aus allen Box-Dateien die Wörter in eine Textdatei geschrieben und mit Editor in eine Wortliste umgewandelt:

cat deu-frak.frak2.exp*.box | cut -d " " -f 1 | tr -d '\n' > words.txt
Anschliessend die Liste mit sort sortieren und mit uniq die Dubletten entfernen:

cat words.txt | sort | uniq > ogerman

Die Häufigkeitsliste bekommt man mit

cat words.txt |sort -fd  | uniq -c | sort -n -r >  freq
Mit gnumeric noch schnell die beiden Spalten Häufigkeit und Wort vertauschen.

Die Schritte des Trainings habe ich in einem Script zusammengefasst, ein alternatives Script findet sich unter https://github.com/paalberti/tesseract-dan-fraktur/blob/master/deu-frak/buildscript.sh:

#!/bin/bash
rm -f *.tr *.txt deu-frak.inttemp deu-frak.normproto deu-frak.pffmtable deu-frak.shapetable deu-frak.traineddata deu-frak.unicharset pffmtable unicharset
for i in $(seq 0 5); do
tesseract deu-frak.frak2.exp$i.tif deu-frak.frak2.exp$i nobatch box.train
done
unicharset_extractor deu-frak.frak2.exp0.box deu-frak.frak2.exp1.box deu-frak.frak2.exp2.box deu-frak.frak2.exp3.box deu-frak.frak2.exp4.box deu-frak.frak2.exp5.box
#mftraining -F font_properties -U unicharset -O unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr
cat unicharset | sed -e "s/^\([æøåäöüâêàèéçßſ][a-z]*\) 0/\1 3/" \
  -e "s/^\([ÆØÅÄÖÜÂÊÀÈÉÇ][a-z]*\) 0/\1 5/" \
  -e "s/^\([«»„”·§—ɔ–]\) 0/\1 10/" \
  -e "s/^ɔ 3 /ɔ 10 /" \
  -e "s/^½ 0/½ 8/" | sed -e "s/^\([æøåäöüâêàèéçßa-zÆØÅÄÖÜÂÊÀÈÉÇA-Zſ].*\) NULL /\1 Latin /" \
  -e "s/^\([«»„”·§—ɔ–[:punct:][:digit:]].*\) NULL /\1 Common /" \
  -e "s/^\(&c .*\) Common /\1 Latin /" > unicharset.edited
#mftraining -F font_properties -U unicharset -O unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr
shapeclustering -F font_properties -U unicharset.edited deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr
mftraining -F font_properties -U unicharset.edited -O deu-frak.unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr

cntraining deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr
wordlist2dawg ogerman deu-frak.word-dawg deu-frak.unicharset
wordlist2dawg freq.txt deu-frak.freq-dawg deu-frak.unicharset
mv inttemp deu-frak.inttemp
mv normproto deu-frak.normproto
mv shapetable deu-frak.shapetable
mv pffmtable deu-frak.pffmtable
combine_tessdata deu-frak.
Hat alles funktioniert existiert im Verzeichnis tess_train/ die Datei deu-frak.traineddata, die für das OCR der anderen Seiten interessant ist.

OCR über alle Seiten

Zurück im Hauptverzeichnis, geht es nun ans Eingemachte. Tesseract kann man über die Variable TESSDATA_PREFIX mitteilen, wo es die OCR-Trainingsdaten findet.
Tesseract sucht im angegebenen Verzeichnis nach dem Verzeichnis tessdata/, ich kopiere dazu aus tess_train/ die deu-frak.traineddata.
Um jetzt für alle im Verzeichnis ppm_single/ befindlichen Einzelseiten, eine optische Zeicherkennung zu machen, benutze ich folgenden Aufruf, der im Verzeichnis txt/ die Text-Dateien erzeugt:


export TESSDATA_PREFIX=/tmp/Bunte_Bilder_aus_dem_Sachsenlande/
for i in ppm_single/*.ppm; do echo $i; convert $i /tmp/img.tif; tesseract /tmp/img.tif txt/$(basename $i '.ppm') -l deu-frak; done
Alternativ kann tesseract auch hOCR ausgeben. hOCR ist ein HTML/XML Format, welches im Rahmen von Google Ocropus entwickelt wurde und die Zuordung erkannter Text, Struktur und die zugrundeliegenden Bilder ermöglicht. Es wird mittlerweile von einer großen Anzahl an OCR-Programmen unterstützt. Eventuell erzeuge ich das hOCR mit, um ggf. daraus leichter das EPub-Format zu erzeugen.

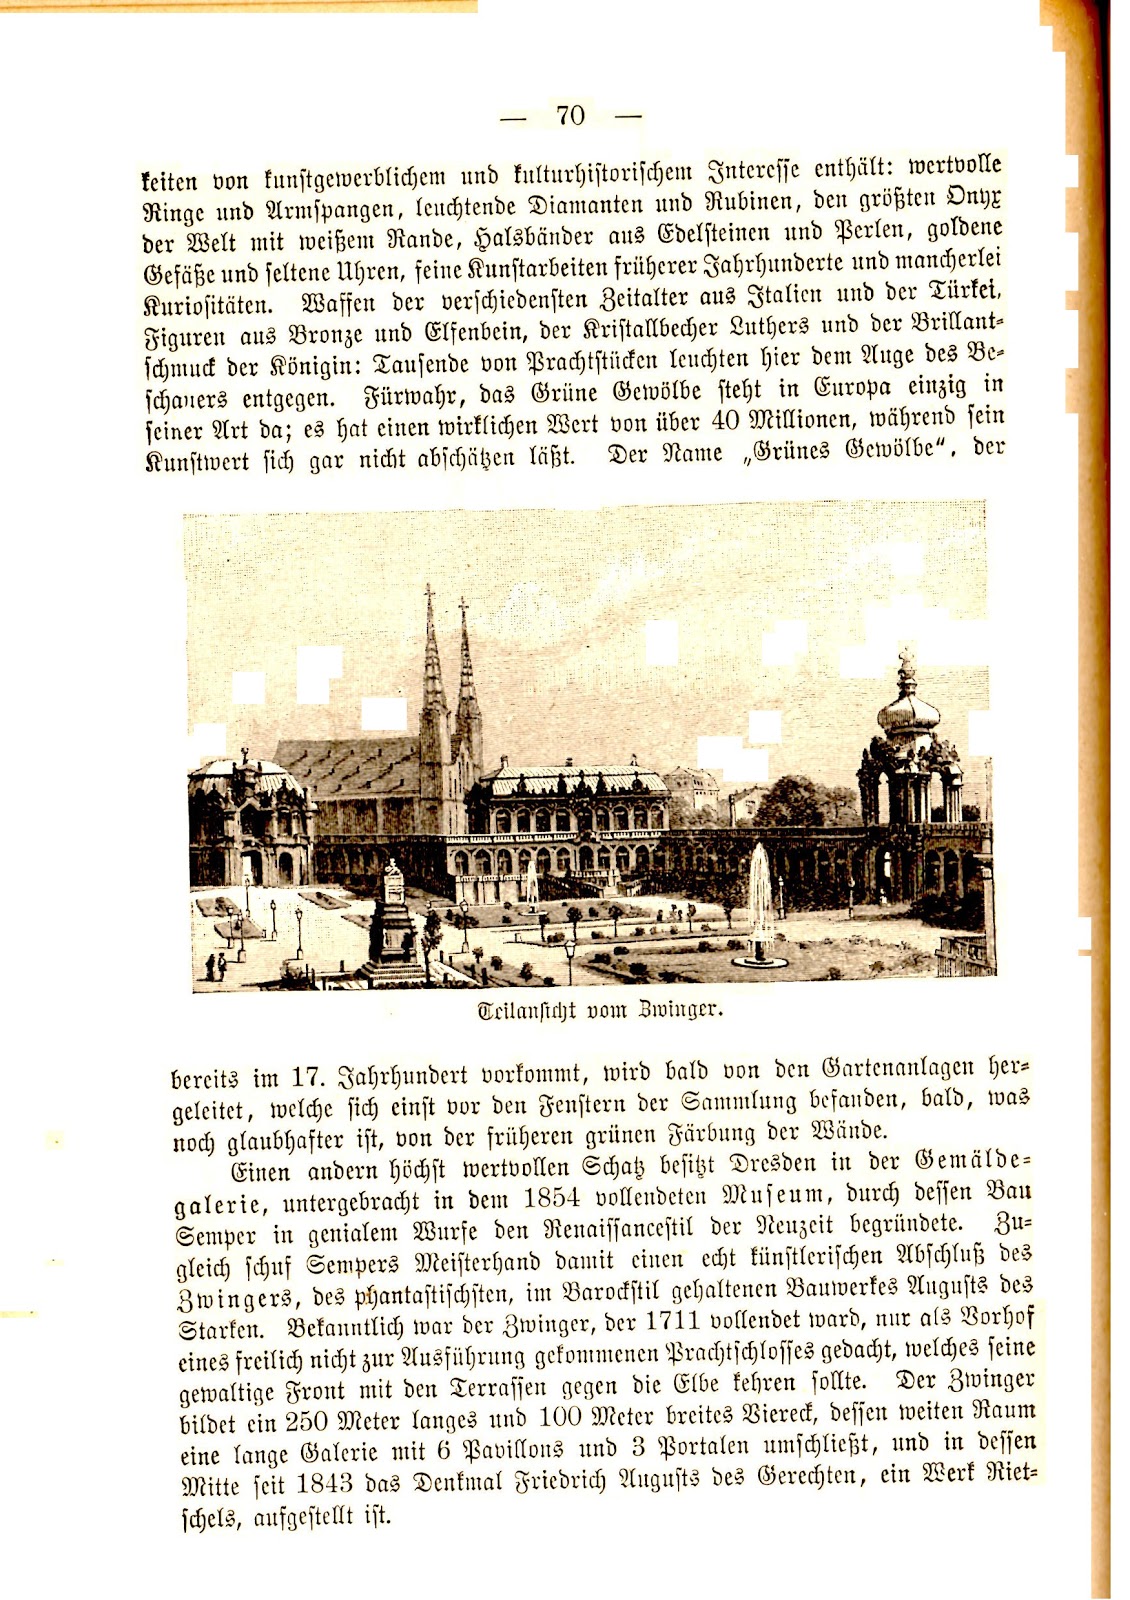
OCR Ergebnis am Beispiel-Text der Seite 70


_.70—

keiten von kunſtgeioerblichem und knltiirhiſtoriſcheiii Jntereſſe enthält: wertvolle
Ringe und Ariuſpangen, lenchtende Dianianten und Rubinen, den größten Onyx
der Welt mit weißeiii Rande, Halsbäiider aus Edelſteinen und Perlen, goldene
Geſäße und ſeltene Uhren, ſeine Knnſtarbeiten früherer Jahrhnnderte und mancherlei
Kurioſitäten. Waffen der verſchiedenſten Zeitalter aus Jtalien und der Türkei,
Figuren aus Bronze und Elſenbein, der Kriſtallbecher Luthers und der Brillant-
ſchinuck der Königin: Tauſende von Prachtſtiicken leuchten hier dem Auge des Ve-
ſchauers entgegen. Fiirwahr, das Grüne Gewöll)e ſteht in Europa einzig in
ſeiner Art da; es hat einen wirklichen Wert von über 40 Millionen, während ſein
Kunſtwert ſich gar nicht abſchätzen läßt. Der Name ,,Griines Gewölbe«, der


bereits im 17. Jahrhundert vorkoniint, wird bald von den Gartenaiilageii her-
geleitet, welche ſich einſt vor den Fenſtern der Samiiiluiig beſanden, bald, was
noch glaubhaſter iſt, von der ſriiheren griinen Färbung der Wände.

Einen andern höchſt wertvollen Schatz beſitzt Dresden in der Gemälde-
galerie, uutergebracht in dem 1854 vollendeten Muſeum, durch deſſen Bau
Semper in genialem Wurſe den Reuaiſſaneeſtil der Neuzeit begri'uidete. Zu-
gleich ſchuſ Seinpers Nieiſterhand damit einen echt künſtleriſchen Abſchliiß des
Zwingers, des pl)antaſtiſchſteii, im Barockſtil gehaltenen Bauwerkes Auguſts des
Starken. Bekaniitlich war der Zwinger, der 1711 vollendet ward, nur als Borhoſ
eines ſreilich nicht zur Ausſiihruiig gekommenen Prachtſchloſſes gedacht, welches ſeine
gewaltige Front mit den Terraſſen gegen die Elbe kehren ſollte. Der Zwinger
bildet ein 250 Meter langes und 1()0 Meter breites Biereck, deſſen weiten Rauin
eine lange Galerie mit 6 Pavillons und 3 Portalen umſchließt, und in deſſen
Mitte ſeit 1843 das Denkmal Friedrich Auguſts des Gerechten, ein Werk Riet-
ſchels, auſgeſtellt iſt.

Donnerstag, 22. November 2012

Teil 4, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"

Warum Tesseract


Jetzt geht es ans Eingemachte. Da das gescannte Buch einen eigenen Font in Fraktur verwendet, ist es notwendig diesen Font zu trainieren um später möglichst wenig Nacharbeit zu haben.

Als OCR-Engine für die Texterkennung nutze ich Tesseract. Im Bereich freier Software sind noch cuneiform und ocropus halbwegs brauchbar. Ersteres kommt mit zuwenig Dokumentation und fällt daher fürs Trainieren der Fonts weg. Letzteres ist schwierig zu kompilieren und die Debian-Variante ist nocch wenig brauchbar.

Tesseract in Version 3 funktioniert ganz gut und ist für den gewünschten Zweck gut genug.

Hartes Training


Um Tesseract zu trainieren folge ich der Anleitung unter http://code.google.com/p/tesseract-ocr/wiki/TrainingTesseract3. Hier nochmal die einzelnen Schritte:

  • mkdir tess_train
  • cd tess_train/
  • convert ../ppm_single/img012.ppm deu-frak2.exp0.tif
  • TESSDATA_PREFIX=./ tesseract -psm 6 -l deu-frak deu-frak.frak2.exp0.tif deu-frak.frak2.exp0 batch.nochop makebox

convert ist Teil von ImageMagick und kopiert die Scanseite ins von tesseract erwartete TIFF-Format.  Anschliessend wird ein box-file erzeugt, welches die Koordinaten der erkannten Symbole enthält.

Mit Hilfe von dem unter http://sourceforge.net/projects/vietocr/files/jTessBoxEditor/ zu findenden jTessBoxEditor weise ich den grafischen Symbolen den korrekten Unicode zu. Korrekt heißt auch, Besonderheiten, wie das lange 'S' zu berücksichtigen.  Dies dauert eine Weile, hier ein Screenshot:

Anschliessend wird tesseract trainiert. Dazu später mehr.

Dienstag, 20. November 2012

Teil 3, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"

Die verflixte Doppelseite


Wie im letzten Post festgestellt, hat die Doppelseitentrennung nicht sauber funktioniert.

Ursache ist, daß über ein Histogramm entlang der x-Achse versucht wird den dunklen Mittelbalken zu finden, was bei Seiten, die entweder leer sind oder Bilder enthalten nicht sauber funktioniert.


unpaper bietet die Möglichkeit den Balkenbereich einzugrenzen. Ein anderes Problem war, daß ich unpaper vergessen hatte zu sagen, daß es sich bei der Eingabe um Doppelseiten handelt.

Der komplette Aufruf sieht daher so aus:

unpaper --layout double -op 2 -mw 30,30 -dn left,right,top,bottom -dr 5 ppm/img%03d.ppm ppm_single/img%03d.ppm

Und, voila, die Doppelseiten sind sauber getrennt.


Teil2, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"

Kurzausflug Speicherplatz

Wie ich im vorigen Beitrag schrieb, hatte ich aus Platzgründen die Scans als JPEG abgespeichert. Pro Scanseite macht das ca. 1,2 MB. Bei der Konvertierung arbeite ich im folgenden auf Bitmapebene, so das pro Scanseite 25MB anfallen.

Für jedes Zwischenergebnis braucht es also genug Platz.

Gerade drehen

Mein Scanner scannt im A4 Format und die Seiten habe ich als Doppelseiten gescannt, die wie folgt aussehen:


Leider erwartet jeder spätere Verarbeitungsschritt die  Seiten als Doppelseiten, also genau um 90° gedreht.

Hier hilft mir ImageMagick weiter, mit dem ich wie folgt im Verzeichnis ppm/ die neuen Bilder rotiere und gleichzeitig konvertiere. PPM ist ein Bitmapformat (kommt aus der Unix-Ecke). Da zum Beispiel unpaper dieses Format verarbeiten kann, sieht mein Aufruf so aus:
 
for i in *.jpg; do convert $i -rotate 90 ppm/$(basename $i ".jpg").ppm; done

Nun habe ich im Unterverzeichnis die korrekt gedrehten Bilder:


Doppelseiten auftrennen


Leider liegen meine Scans immer noch als Doppelseite vor. Mit unpaper kann ich die Doppelseiten auftrennen. Dazu erzeuge ich zum einen ein neues Verzeichnis ppm_single/ und rufe dann unpaper mit den File-Pattern "img%3d.ppm" auf. %3d gibt hierbei an, daß 3 Ziffern enthalten sind. Die Option "-op 2" splittet mir dann die Doppelseiten auf. Der komplette Aufruf lautet:

unpaper -op 2 ppm/img%03d.ppm ppm_single/img%03d.ppm

Der ganze Prozess dauert ein Weilchen und ich trinke erstmal 'nen Kaffee.

PS.: unpaper macht eigentlich noch ein paar Sachen mehr, zum Beispiel korrigiert es noch leichte Verdrehungen und entfernt Fliegendreck, lest dazu mal die Doku :)

Erstes PDF erzeugen


Da wir ja ein erstes Ergebnis haben wollen, bauen wir uns schnell die Seiten als PDF zusammen. Dazu wieder mit ImageMagick aus den PPMs ein JPEGs erzeugen:

for i in ppm_single/*.ppm; do convert $i jpg/$(basename $i ".ppm").jpg; done


Jetzt habe wir im Verzeichnis jpg/ alle Seiten als JPEG vorliegen. Diese müssen mit Hilfe von pdfjoin, einem Programm aus der TexLive-Distribution, zusammengefügt werden. Es gibt aber auch andere Möglichkeiten, zum Beispiel mit pdftk.

pdfjoin --outfile bilder_aus_dem_sachsenlande.pdf jpg/*.jpg

Das PDF hat 416 Seiten und ist 238MB groß. Wenn wir statt JPEG pdfjoin mit PNG genutzt hätten, wäre das PDF 1,6GB groß geworden.

Die Seitenaufteilung hat erstmal nur suboptimal funktioniert. Darum kümmern wir uns später nochmal.

DJVu erzeugen

Was ist denn DJVu?

Das ist ein krasses Kompressionsformat, ursprünglich für die Online-Präsentation von Bibliotheks- und Archivdaten entwickelt. Archive.org verwendet djvu für das Millon Book Project Hinter djvu stehen zwei Prinzipien:

  • Trenne Scans in Vorder- und Hintergrundebenen auf
  • Komprimiere jede der Ebenen mit dem bestmöglichen Verfahren

Eine Seite unseres gescanntes Buches besteht zum einen aus vergilbtem Papier, welches den Hintergrund darstellt. Dieser Hintergrund ist durch Farbverläufe, relativ weiche Übergänge und geringe Kontraständerungen gekennzeichnet. Der Hintergrund wird daher mit Wavelets kodiert, ähnlich wie JPEG2000 diese verwendet.

Zum anderen besteht die Seite aus Buchstaben die im Vergleich zur Umgebung einen sehr hohen Kontrast aufweisen. Dort interessiert es niemanden, ob diese innerhalb der Schrift leichte Farbnuancen aufweisen. Und vermutlich kommen auf der Seite auch viele gleiche Buchstaben vor. Diese Informationen werden ausgenutzt und die Buchstaben als Verweis auf eine Tabelle gespeichert.

Kurzum, djvu ist richtig krasses Zeugs und wir bekommen eine gegenüber PDF deutlich kleinere Datei hin. Für weitere Informationen schaut Euch djvulibre an. :)

Gut, gut, wie erzeuge ich das denn?


Auf djvulibre von der obengenannten Webseite (aber auch bei Linux-Distributionen in der Regel dabei) gibt es das Programm pdf2djvu. Ein PDF haben wir schon, und wir können folgenden Aufruf nutzen:

pdf2djvu --lossy -j0 --fg-colors=black --bg-subsample=4 -o bilder_aus_dem_sachsenlande.djvu bilder_aus_dem_sachsenlande.pdf


Alternativ können wir den Online-Konverter nutzen.

So, das war es erstmal, die fertige djvu-Datei  ist 160MB groß.

Demnächst geht es weiter mit der Korrektur der Seitentrennung, der OCR-Verarbeitung und wie wir uns langsam Richtung Ebook vortasten.

Update 2012-11-21


Besser als das Tool pdf2djvu ist djvudigital, weil es einen besseren Algorithmus zum Auftrennen der Bildebenen in Hinter- und Vordergrund benutzt. Leider benötigt djvudigital einen speziell angepassten Ghostscript.

Daher entschied ich mich statt aus dem PDF aus den Einzelseiten ein DJVU zu erzeugen. Dies geht mit dem Programm didjvu wie folgt:


didjvu bundle --output bilder_aus_dem_sachsenlande.djvu ppm_single/img*.ppm


Die erzeugte djvu-Datei ist nur noch 21MB groß, hier der Download-Link: https://www.dropbox.com/s/nzij79ulmuh64m7/bilder_aus_dem_sachsenlande.djvu

Viel Spaß beim Durchblättern, demnächst geht es weiter...