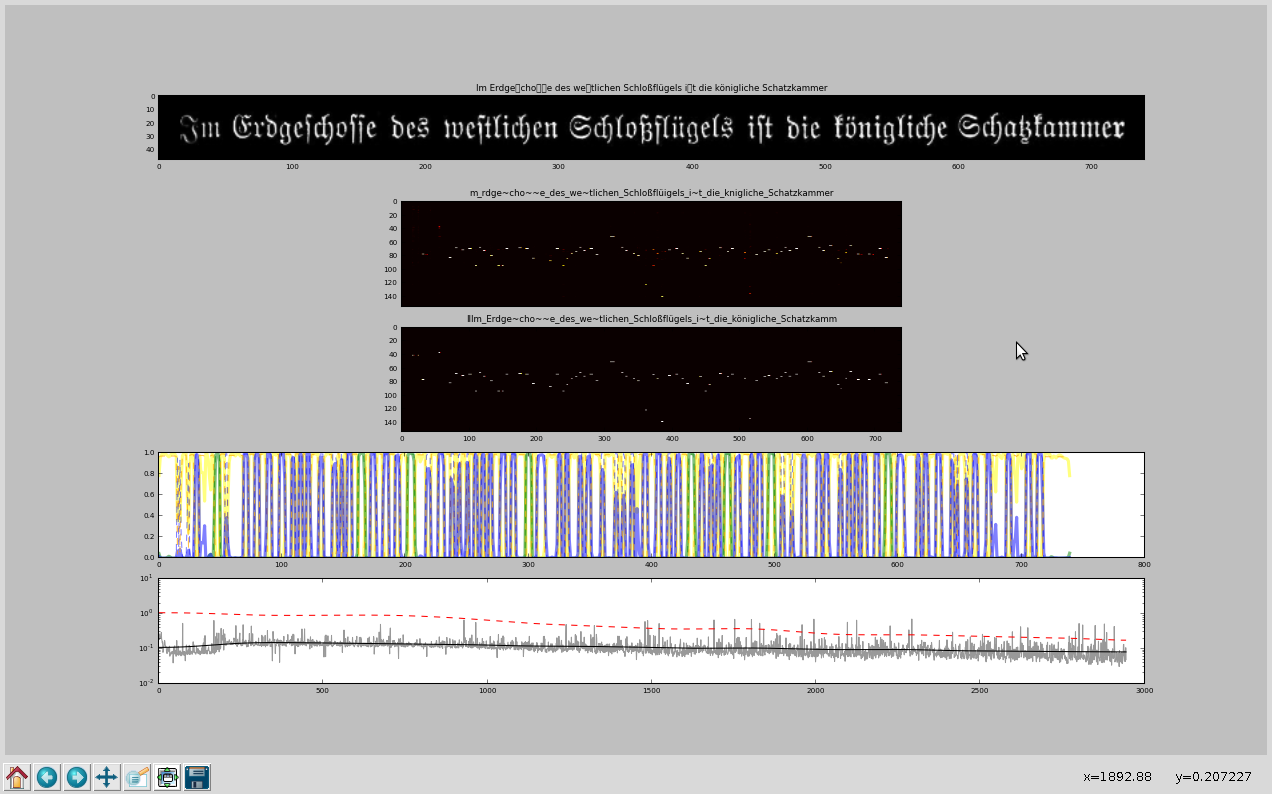
Update
Ergänzt um Wörterbucherzeugung und Häufigkeitsliste. Korrektur Fehler OCR-Text (falsche Datei erwischt).
Seitenweises Zeichenerfassen
Wie im
letzten Artikel beschrieben, habe ich mir zur Verbesserung der Erkennungsgenauigkeit von
Tesseract 3 Paare von
TIFF-Dateien und
Box-Dateien erzeugt, um die Zuordnung von Blobs zu den Zeichen im UTF-8 Format mit Hilfe von
jTessBoxEditor festzulegen.
Ich hatte dazu 5 Seiten aus dem Originalscan ausgewählt, zwei davon aus dem Inhaltsverzeichnis, um auch Ziffern zu erfassen.
Diese Zuordnung hat relativ lange gedauert, da ich pro Seite ca. 2500 Zeichen editieren mußte.
Hartes Training
Das Training von
Tesseract besteht aus mehreren Schritten. Wichtig ist die Erzeugung der
font_properties Datei, die angibt, daß der Font gebrochen ist, sprich als
Frakturschrift daherkommt. Dazu wird folgende Zeile eingetragen:
frak2 0 0 0 0 1
Ebenfalls wichtig sind zwei Dinge, erstens eine Wortliste, die auch Besonderheiten, wie das
lange S korrekt enthalten sollte, zweitens ein Häufigkeitsliste, die angibt, welche Wörter, wie häufig vorkommen. Wenn man hier keine Arbeit reinstecken möchte, kann man die Dateien vom
deu-frak-Paket verwenden (ist bei Tesseract dabei), die aber keine Unterstützung für langes S beinhaltet.
Mein Weg war daher folgender. Aus den Box-Dateien habe ich die Wörter extrahiert und daraus meine Wortliste gebaut
.
Dazu habe ich mit folgendem Aufruf aus allen Box-Dateien die Wörter in eine Textdatei geschrieben und mit Editor in eine Wortliste umgewandelt:
cat deu-frak.frak2.exp*.box | cut -d " " -f 1 | tr -d '\n' > words.txt
Anschliessend die Liste mit
sort sortieren und mit
uniq die Dubletten entfernen:
cat words.txt | sort | uniq > ogerman
Die Häufigkeitsliste bekommt man mit
cat words.txt |sort -fd | uniq -c | sort -n -r > freq
Mit gnumeric noch schnell die beiden Spalten Häufigkeit und Wort vertauschen.
Die Schritte des Trainings habe ich in einem Script zusammengefasst, ein alternatives Script findet sich unter
https://github.com/paalberti/tesseract-dan-fraktur/blob/master/deu-frak/buildscript.sh:
#!/bin/bash
rm -f *.tr *.txt deu-frak.inttemp deu-frak.normproto deu-frak.pffmtable deu-frak.shapetable deu-frak.traineddata deu-frak.unicharset pffmtable unicharset
for i in $(seq 0 5); do
tesseract deu-frak.frak2.exp$i.tif deu-frak.frak2.exp$i nobatch box.train
done
unicharset_extractor deu-frak.frak2.exp0.box deu-frak.frak2.exp1.box deu-frak.frak2.exp2.box deu-frak.frak2.exp3.box deu-frak.frak2.exp4.box deu-frak.frak2.exp5.box
#mftraining -F font_properties -U unicharset -O unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr
cat unicharset | sed -e "s/^\([æøåäöüâêàèéçßſ][a-z]*\) 0/\1 3/" \
-e "s/^\([ÆØÅÄÖÜÂÊÀÈÉÇ][a-z]*\) 0/\1 5/" \
-e "s/^\([«»„”·§—ɔ–]\) 0/\1 10/" \
-e "s/^ɔ 3 /ɔ 10 /" \
-e "s/^½ 0/½ 8/" | sed -e "s/^\([æøåäöüâêàèéçßa-zÆØÅÄÖÜÂÊÀÈÉÇA-Zſ].*\) NULL /\1 Latin /" \
-e "s/^\([«»„”·§—ɔ–[:punct:][:digit:]].*\) NULL /\1 Common /" \
-e "s/^\(&c .*\) Common /\1 Latin /" > unicharset.edited
#mftraining -F font_properties -U unicharset -O unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr
shapeclustering -F font_properties -U unicharset.edited deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr
mftraining -F font_properties -U unicharset.edited -O deu-frak.unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr
cntraining deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr
wordlist2dawg ogerman deu-frak.word-dawg deu-frak.unicharset
wordlist2dawg freq.txt deu-frak.freq-dawg deu-frak.unicharset
mv inttemp deu-frak.inttemp
mv normproto deu-frak.normproto
mv shapetable deu-frak.shapetable
mv pffmtable deu-frak.pffmtable
combine_tessdata deu-frak.
Hat alles funktioniert existiert im Verzeichnis
tess_train/ die Datei
deu-frak.traineddata, die für das OCR der anderen Seiten interessant ist.
OCR über alle Seiten
Zurück im Hauptverzeichnis, geht es nun ans Eingemachte. Tesseract kann man über die Variable
TESSDATA_PREFIX mitteilen, wo es die OCR-Trainingsdaten findet.
Tesseract sucht im angegebenen Verzeichnis nach dem Verzeichnis tessdata/, ich kopiere dazu aus tess_train/ die deu-frak.traineddata.
Um jetzt für alle im Verzeichnis
ppm_single/ befindlichen Einzelseiten, eine optische Zeicherkennung zu machen, benutze ich folgenden Aufruf, der im Verzeichnis
txt/ die Text-Dateien erzeugt:
export TESSDATA_PREFIX=/tmp/Bunte_Bilder_aus_dem_Sachsenlande/
for i in ppm_single/*.ppm; do echo $i; convert $i /tmp/img.tif; tesseract /tmp/img.tif txt/$(basename $i '.ppm') -l deu-frak; done
Alternativ kann
tesseract auch
hOCR ausgeben.
hOCR ist ein HTML/XML Format, welches im Rahmen von
Google Ocropus entwickelt wurde und die Zuordung erkannter Text, Struktur und die zugrundeliegenden Bilder ermöglicht. Es wird mittlerweile von einer großen Anzahl an OCR-Programmen unterstützt. Eventuell erzeuge ich das
hOCR mit, um ggf. daraus leichter das
EPub-Format zu erzeugen.
OCR Ergebnis am Beispiel-Text der Seite 70
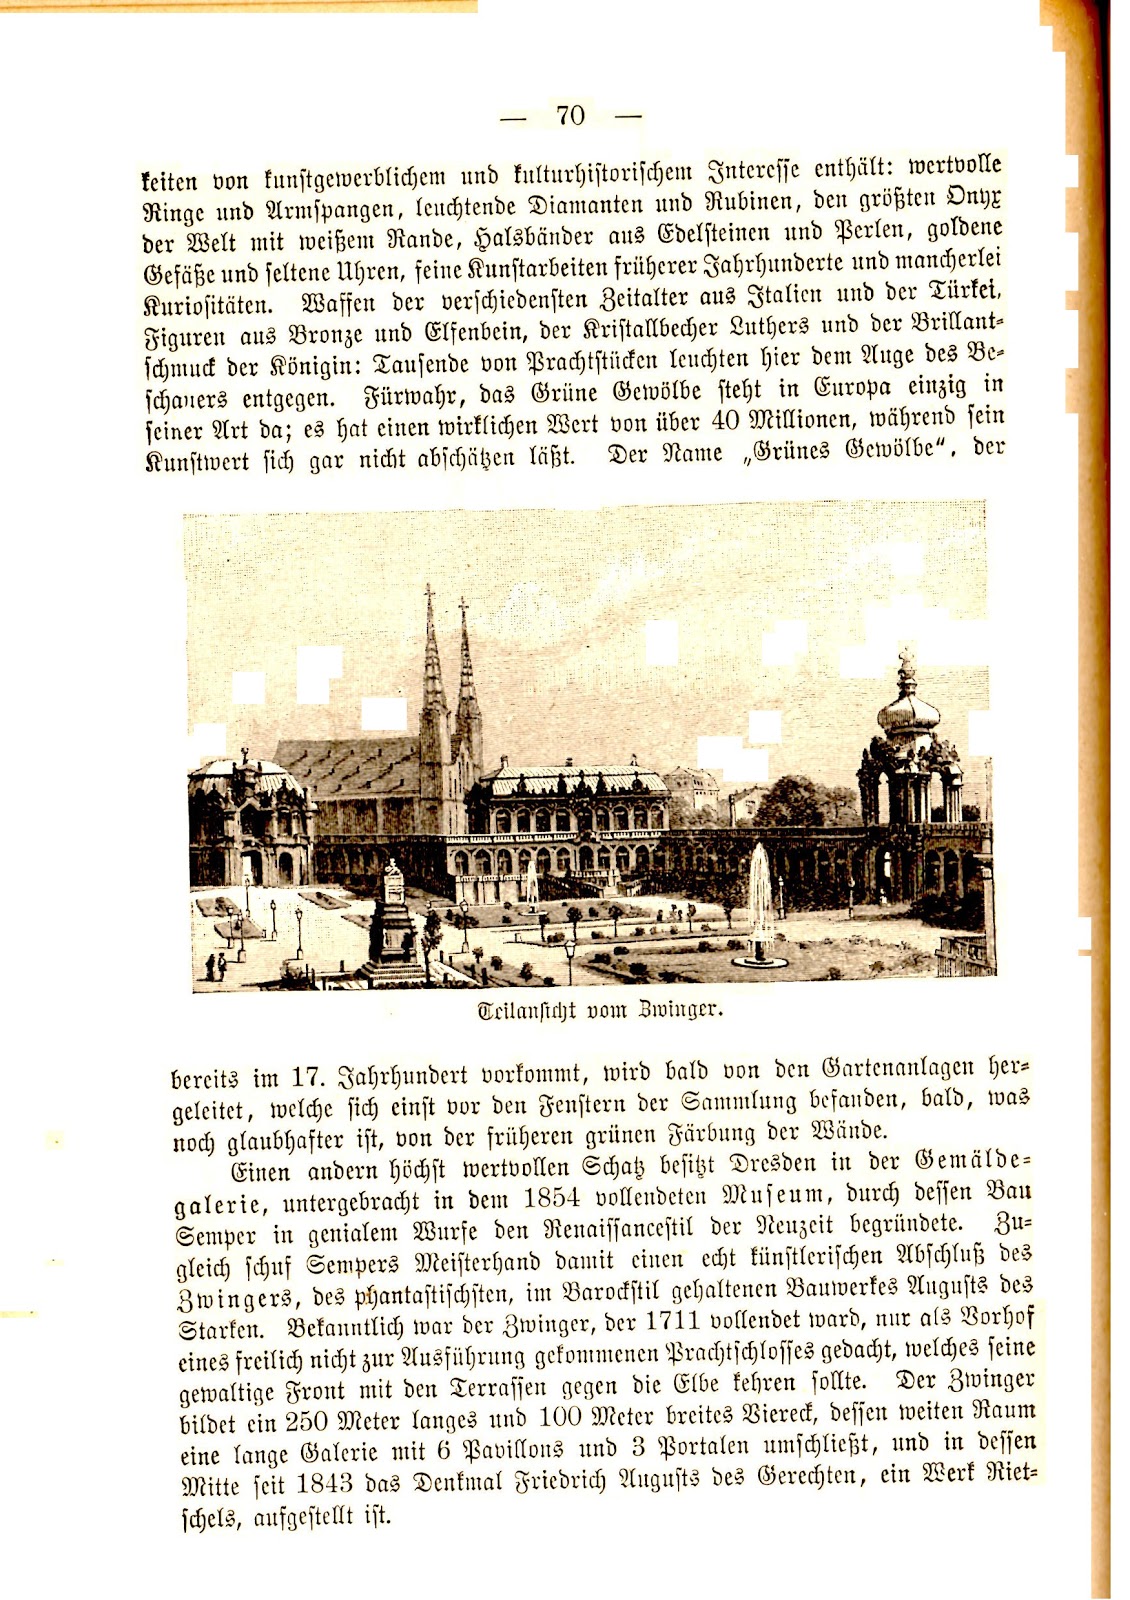
_.70—
keiten von kunſtgeioerblichem und knltiirhiſtoriſcheiii Jntereſſe enthält: wertvolle
Ringe und Ariuſpangen, lenchtende Dianianten und Rubinen, den größten Onyx
der Welt mit weißeiii Rande, Halsbäiider aus Edelſteinen und Perlen, goldene
Geſäße und ſeltene Uhren, ſeine Knnſtarbeiten früherer Jahrhnnderte und mancherlei
Kurioſitäten. Waffen der verſchiedenſten Zeitalter aus Jtalien und der Türkei,
Figuren aus Bronze und Elſenbein, der Kriſtallbecher Luthers und der Brillant-
ſchinuck der Königin: Tauſende von Prachtſtiicken leuchten hier dem Auge des Ve-
ſchauers entgegen. Fiirwahr, das Grüne Gewöll)e ſteht in Europa einzig in
ſeiner Art da; es hat einen wirklichen Wert von über 40 Millionen, während ſein
Kunſtwert ſich gar nicht abſchätzen läßt. Der Name ,,Griines Gewölbe«, der
bereits im 17. Jahrhundert vorkoniint, wird bald von den Gartenaiilageii her-
geleitet, welche ſich einſt vor den Fenſtern der Samiiiluiig beſanden, bald, was
noch glaubhaſter iſt, von der ſriiheren griinen Färbung der Wände.
Einen andern höchſt wertvollen Schatz beſitzt Dresden in der Gemälde-
galerie, uutergebracht in dem 1854 vollendeten Muſeum, durch deſſen Bau
Semper in genialem Wurſe den Reuaiſſaneeſtil der Neuzeit begri'uidete. Zu-
gleich ſchuſ Seinpers Nieiſterhand damit einen echt künſtleriſchen Abſchliiß des
Zwingers, des pl)antaſtiſchſteii, im Barockſtil gehaltenen Bauwerkes Auguſts des
Starken. Bekaniitlich war der Zwinger, der 1711 vollendet ward, nur als Borhoſ
eines ſreilich nicht zur Ausſiihruiig gekommenen Prachtſchloſſes gedacht, welches ſeine
gewaltige Front mit den Terraſſen gegen die Elbe kehren ſollte. Der Zwinger
bildet ein 250 Meter langes und 1()0 Meter breites Biereck, deſſen weiten Rauin
eine lange Galerie mit 6 Pavillons und 3 Portalen umſchließt, und in deſſen
Mitte ſeit 1843 das Denkmal Friedrich Auguſts des Gerechten, ein Werk Riet-
ſchels, auſgeſtellt iſt.