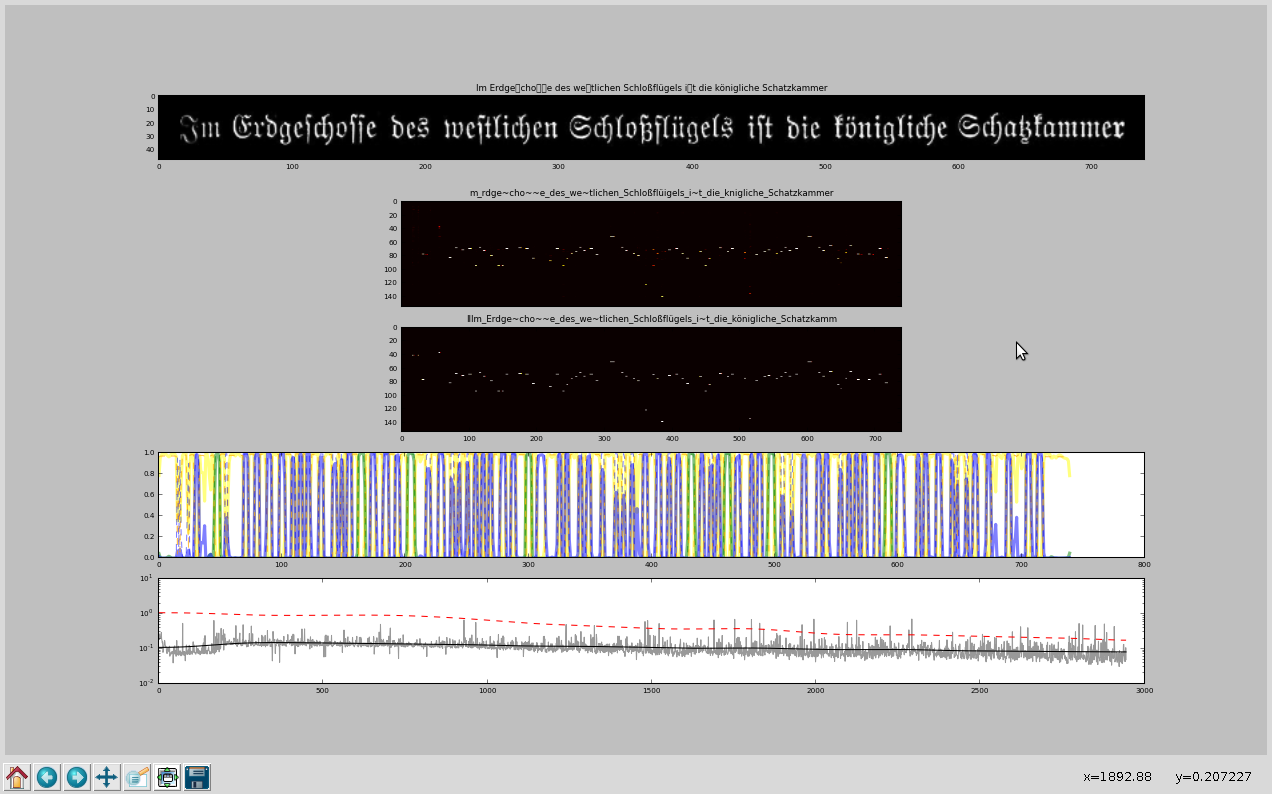
Posts mit dem Label ocr werden angezeigt. Alle Posts anzeigen

Samstag, 31. Dezember 2016

Schicht's Kochbuch Bd. 1

Dieser Tage hatte ich einen alten Artikel von mir gelesen, in dem ich aus "Schicht's Kochbuch" die Sachertorte vorgestellt habe.

Das alte Heftchen ist mittlerweile in einem erbärmlichen Zustand. Es besteht aus Holzschliff und das Papier zerfällt langsam (mehr darüber in http://www.spektrum.de/magazin/gefaehrdung-restaurierung-und-konservierung-von-schriftgut/822535).

Da ich über die Feiertage etwas Zeit hatte, habe ich mich hingesetzt und "Schicht's Kochbuch Bd. I" digitalisiert. Die Scandaten belegten ca. 1,2 GB.

Für das Postprocessing habe ich wie schon beim Dschiu-dschitsu Projekt das Programm Scantailor verwendet.

Die entstandenen TIFF-Seiten hatte ich diesmal doch via didjvu zu einem djvu-File konvertiert:

$> didjvu bundle -o Schichts_Kochbuch_Bd1.djvu *.tif

Mit ocrodjvu habe ich dann noch den OCR-Layer hinzugefügt:

$> ocrodjvu -l deu -e tesseract --in-place Schichts_Kochbuch_Bd1.djvu

Die Kompressionsrate ist beachtlich, aus knapp 98MB TIFF-Dateien entsteht eine nur 3.358.164 Byte große djvu-Datei (eine PDF-Datei wird ca. 19MB groß). Die Texte sind nahezu fehlerfrei von tesseract erkannt wurden.

Alles in allem brauchte ich für die ca. 77 Seiten knapp 10h für Digitalisierung und Nachbearbeitung.

Das Buch ist unter http://andreas-romeyke.de/Schichts_Kochbuch_Bd1.djvu zu finden.

Update  2018-04-02


Durch einen Hinweis von Stefan (unbekannterweise) konnte ich zwei Fehler korrigieren, so stimmte die Reihenfolge der Seiten 24b-26 (die betreffende Lage war lose und falsch eingeordnet) nicht und die Seite 47 war unvollständig gescannt. Leider bin ich erst jetzt dazu gekommen, die beiden Probleme zu korrigieren. Die neue Datei findet sich an og. Stelle (9MB).

Danke nochmal an Stefan für den Hinweis!

Dienstag, 2. Dezember 2014

Sachertorte

Es ist Weihnachtszeit und da der letzte Beitrag etwas her ist, gibt es heute ein Rezept aus „Schicht's Kochbuch – ausgewählte Rezepte“
Das Buch ist eigentlich eines von drei Heftchen, hier aus dem 1. Band, Mehlspeisen, im Druck von A. Haase, Prag. Die DNB verzeichnet als Erscheinungsjahr 1928-1931 (http://d-nb.info/56088897X).


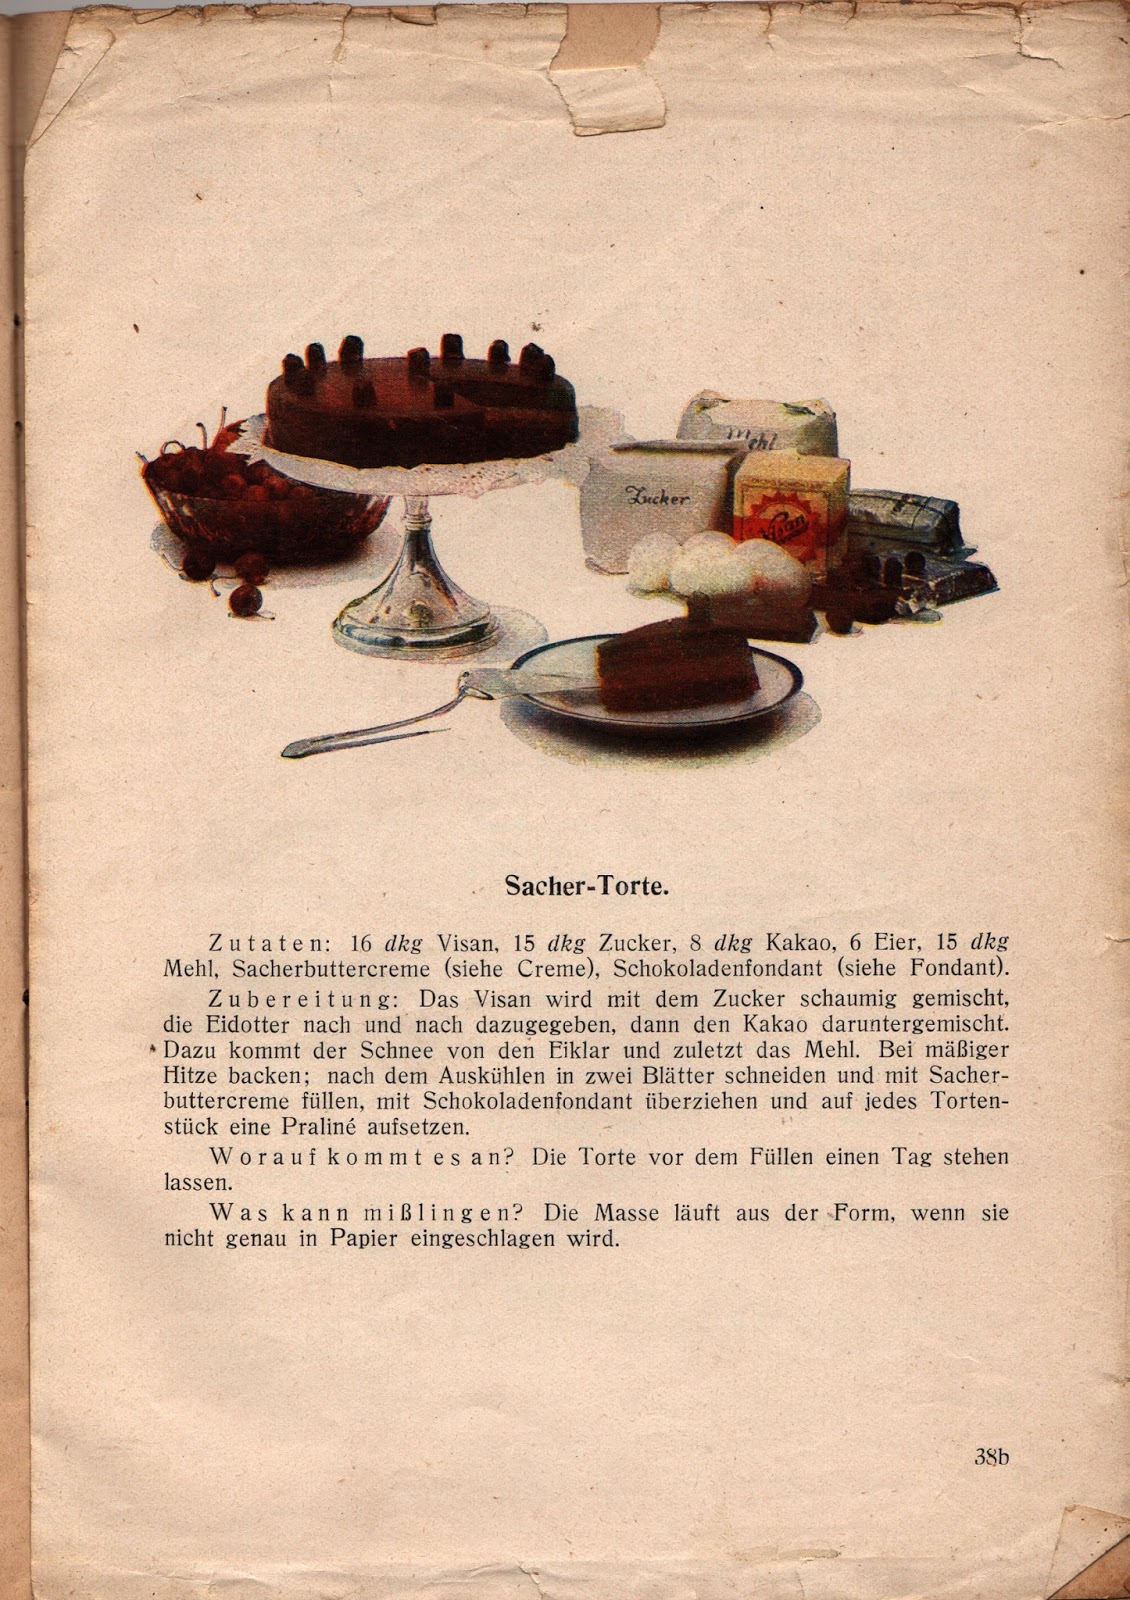
Charakteristisch ist die minimalistische Darstellung der Rezepte.Hier das Rezept für Sachertorte aus Seite 38b:


Das Rezept in maschinenlesbarer Form:

Sacher-Torte.

Zutaten: 16 dkg Visan, 15 dkg Zucker, 8 dkg Kakao, 6 Eier, 15 dkg
Mehl, Sacherbuttercreme (siehe Creme), Schokoladenfondant (siehe Fondant).

Zub ereitung; DasVisan wird mit dem Zucker schaumig gemischt,
die Eidotter nach und nach dazugegeben, dann den Kakao daruntergemischt.

*Dazu kommt der Schnee von den Eiklar und zuletzt das Mehl. Bei mäßiger '

Hitze backen; nach dem Auskühlen in zwei Blätter schneiden und, mit Sacher-
buttercreme füllen, mit Schokoladenfondant überziehen und auf jedes Torten-
stück eine Praline aufsetzen. w ’

W o r a uf k o m mt e s a n? Die Torte vor dem Füllen einen Tag stehen
lassen. '

Was kann mißlingen? Die Masse läuft aus der Form, wenn sie
nicht genau in Papier eingeschlagen wird.
Die Sacher-Buttercreme wird auf S. 31 beschrieben:


Das Rezept in maschinenlesbarer Form:

 Sacherbuttercreme.

Z u t a t e n: 12 1/2 dkg Visan, 12 1/2 dkg Zucker, 2 Eigelb, 10 dkg Tunkmasse.
Z u b e r e i t u n g: Das Eigelb wird schaumig geschlagen, der Zucker wird
zum schwachen Flug gekocht und in einem schwachen Strahl in die flaumige Eigelbmasse hineingezogen; das Ganze dann kalt geschlagen. Nachher rührt
man es in das Visan, welches unterdessen schaumig gerührt wurde. Nun mischt man noch die aufgelöste Tunkmasse darunter.
W o r a u f  k o m m t e s a n? Das Eigelb gut aufschlagen.
Was kann m iß l in gen? Die Tunkmasse wird bröslig, wenn sie zu
warm aufgeweicht wird.
Das Ergebnis entstammt (ohne weitere Korrektur) der OCR mit dem folgenden Aufruf von Tesseract 3.03:
$> tesseract Schichts_Kochbuch_Bd1_38b.png Schichts_Kochbuch_Bd1_38b -l deu
 

Dienstag, 25. Juni 2013

Binarisierung

Vorwort


Mit der Binarisierung ist das Überführen eines Farb- oder Graustufenbildes in eine monochrome, dh. nur schwarze oder weiße Pixel enthaltene Dartsellung.

Gescannte Vorlagen binarisiert man aus zwei Gründen, zum einen sparen monochrome Bilder Speicherplatz, zum anderen soll mit der Binarisierung versucht werden, den Kontrast der Scanvorlagen so zu erhöhen, daß eine eindeutige Zuordnung zwischen Vordergrund und Hintergrund möglich ist.

Schwierig bis unsinnig ist die Binarisierung dann, wenn man mehrfarbige Schrift ev. sogar auf mehrfarbige Hintergründe hat. Auf dieses Problem gehe ich in einem zukünftigen Beitrag ein. Nicht sinnvoll ist Binarisierung von Photos (abgesehen von einer künstlerisch gewollten Gestaltung).

Schwellwert-Variante


Das einfachste Verfahren ist das Schwellwertverfahren. Dazu wandeln wir das Eingangsbild im RGB-Modus zum Beispiel nach der Formel

  Y = 0.212671 * R + 0.715160 * G + 0.072169 * B;


in ein Graustufenbild um.
(aus: ITU-R Recommendation BT.709, Basic Parameter Values for the HDTV
Standard for the Studio and for International Programme Exchange (1990),
[formerly CCIR Rec. 709], ITU, 1211 Geneva 20, Switzerland.)

Wenn wir nun einen geeigneten Schwellwert zwischen 0.0 und 1.0 finden, haben wir eine einfache Binarisierung erreicht, wie sie zum Beispiel Gimp anbietet.

Globale vs. lokale Anwendung


Der Nachteil des Schwellwertverfahrens wird dann deutlich, wenn wir annehmen der optimale Schwellwert wäre 0.5 und die Schrift ist grau mit Wert 0,5 auf dunklem Hintergrund im ersten Teil des Bildes und weiß mit Wert 1,0 auf hellem Hintergrund mit Wert 0,5 des anderen Teil des Bildes. Würden wir einen globalen Schwellwert anwenden, würde ein Teil der Schrift dann untergehen.
Graustufenbild s/w-Bild mit globalem Threshold
Würden wir stattdessen immer die lokale Umgebung eines Pixels betrachten, zB. 30x30 Pixel um den aktuellen herum, würde das Ergebnis so aussehen:
lokaler Threshold

Nachteilig bei lokalen Verfahren ist die deutlich höhere Rechenzeit, da für jeden Pixel die nähere Umgebung angeschaut werden muß.

Verschiedene Verfahren

Es gibt etliche Verfahren, den "optimalen" Schwellwert, sowohl global, wie auch lokal zu bestimmen. Als Test habe ich das oben schon gezeigte Eingangsbild genommen. In der Praxis hat sich lokales Sauvola mit Fenster von 30x30 Pixeln bewährt.

Hier die Ergebnisse:

gescannt
niblack local 30x30, 0,2
Sauvola global
Sauvola local, 30x30
Gimp, threshold


Kurzfassung Algorithmus Niblack

Beim niblack-Algorithmus, wird der Mittelwert m und die Standardabweichung s über alle Pixelwerte gebildet und nach folgender Vorschrift angewandt:

T = m + K* s

mit K=0,2

Wenn der Pixelwert P > T ist wird er weiß eingefärbt, sonst schwarz.

Kurzfassung Algorithmus Sauvola

Bei Sauvola sieht die Formel ein klein wenig anders aus:

T = m + ( 1 + (0,6 * (s / r - 1.0))

mit r = 128 für 256 Grauwerte.

Weiterführende Infos

Ebenfalls einen guten Eindruck der verschiedenen Verfahren bietet Stackoverflow.
Und  bei Sezgin and Sankur findet man im "Survey over image thresholding techniques and quantitive performance evaluation", Journal of Electronic Imaging 13(1), 146-165 (January 2004) eine Überblicksanalyse.


Dienstag, 21. Mai 2013

Ocropus 0.7 – Training

Trainingsausgabe Ocropus 0.7

Im letzten Beitrag hatte ich einen ersten Vergleich zwischen Ocropus 0.7 und Tesseract 3.02 gezogen. Da leider die mitgelieferten Dateien für Fraktur keine Unterstützung für das lange-S beinhalten, muß ich Ocropus selber trainieren.

Unterschied Tesseract- und Ocropus Trainingsdaten


Leider hat sich bei Ocropus 0.7 der Trainingsmodus geändert. Um die gleichen Dateien, wie Tesseract 3.02 zu verwenden, habe ich ein Script geschrieben, welches die Tesseract-Boxfiles und zugehörige TIFF-Dateien so umwandelt, daß die von Ocropus erwarteten zeilenbasierten PNG-Dateien mit zugehörigen Text-Dateien erzeugt werden.

Aus dem tess_train Verzeichnis:

tess_train
├── bigram_words
├── deu-frak.bigram-dawg
├── deu-frak.config
├── deu-frak.frak2.exp0.box
├── deu-frak.frak2.exp0.tif
├── deu-frak.frak2.exp0.tr
├── deu-frak.frak2.exp0.txt
:
├── deu-frak.frak2.exp9.box
├── deu-frak.frak2.exp9.tif
├── deu-frak.frak2.exp9.tr
├── deu-frak.frak2.exp9.txt
├── deu-frak.freq-dawg
├── deu-frak.inttemp
├── deu-frak.normproto
├── deu-frak.number-dawg
├── deu-frak.pffmtable
├── deu-frak.punc-dawg
├── deu-frak.shapetable
├── deu-frak.traineddata
├── deu-frak.unicharambigs
├── deu-frak.unicharset
├── deu-frak.word-dawg
├── font_properties
├── freq
├── get_bigramword_list.pl
├── get_freqlist.pl
├── get_wordlist.pl
├── number
├── ogerman
├── punc
├── train.sh
├── unicharset
└── unicharset.edited

Sonntag, 21. April 2013

Ocropus 0.7, erste Tests

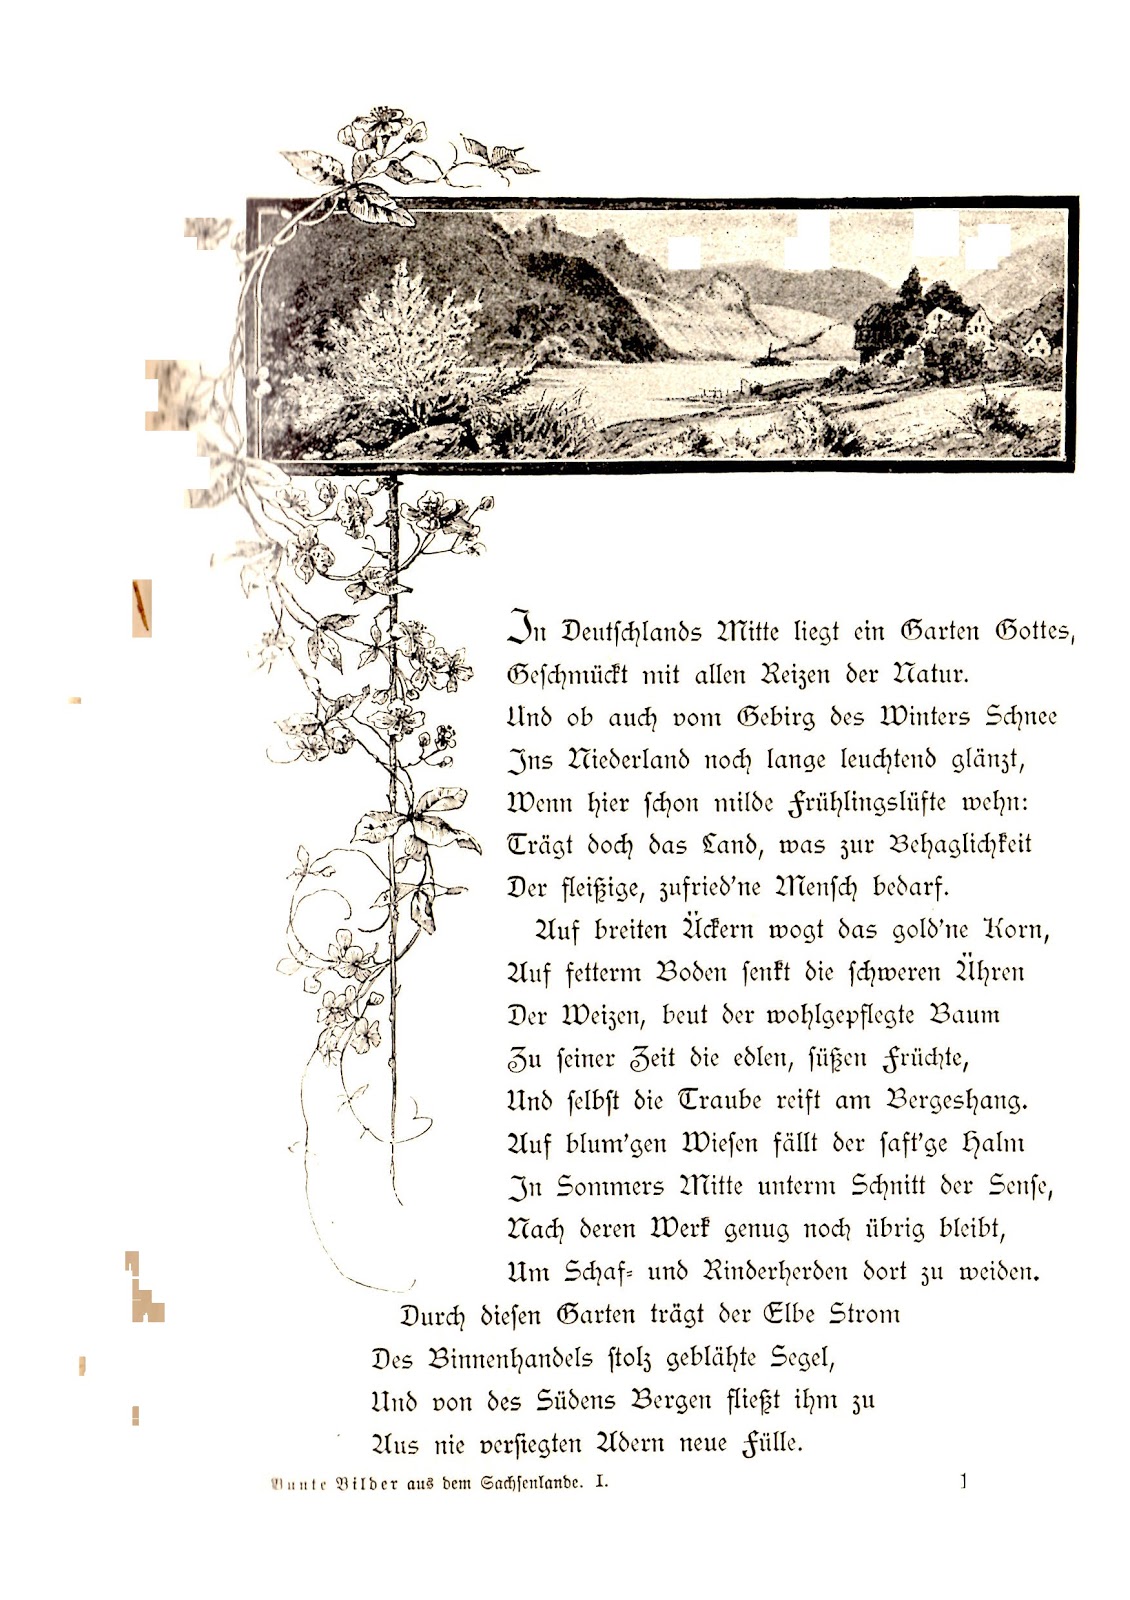
S.99 der »Bunte Bilder aus dem Sachsenlande«,
 Band1, 1902, selbstgescannt
Im April ist Ocropus in der Version 0.7 erschienen und dies war eine gute Gelegenheit zu schauen, wie gut es mit der Erkennungsqualität gegenüber dem trainierten Tesseract 3.02 aussieht.

Installation


Die Installation ist auf der Webseite gut beschrieben und hat diesmal auch unter Debian Wheezy funktioniert:

    $ hg clone -r ocropus-0.7 https://code.google.com/p/ocropus
    $ cd ocropus/ocropy
    $ sudo apt-get install $(cat PACKAGES)
    $ python setup.py download_models
    $ sudo python setup.py install
    $ ./run-test


Test


Als Test habe ich die Seite 99 der »Bunte Bilder aus dem Sachsenlande« genommen, die oben zu sehen ist. Diese Seite enthält ua. zwei Schriftgrößen und ein Bild der Kurfürstin Anna.

Da Ocropus ein Modell für Fraktur mitbringt, habe ich dieses getestet. Als Vorlage benutzte ich die Schritte der run-test.sh wie folgt:

 convert Bunte_Bilder_aus_dem_Sachsenlande/ppm_single/img110.ppm temp/img110.png
 ocropus-sauvola temp/img110.png  -o temp
 ocropus-gpageseg 'temp/????.bin.png'
 ocropus-rpred -m fraktur.pyrnn 'temp/????/??????.bin.png'
 ocropus-hocr 'temp/????.bin.png' -o temp.html
 ocropus-visualize-results temp
 ocropus-gtedit html temp/????/??????.bin.png -o temp-correction.html

Ergebnis


Das Ergebnis läßt sich, bis auf die fehlende Unterstützung des langen-S durchaus sehen.

Hier die Ergebnisse im Vergleich, zuerst Tesseract:

 die Muſik nnd Handarbeit, nainentlich das Drechſeliu Zu den Schiitzenſeſten der
Bürger reiſte er gern. Den Schützengilden verlieh er Böller und Kanonen als Aus-
zeichnung. überhaupt nahm er an den Freuden und Leiden ſeiner Landeskinder
gern teil; er und ſeine Gemahlin ließen ſich oft als Taufpaten wählen und ſtat-
teten Brautleute reichlich aus.

So war er ein trefflicher Landesvater. Sollte er nlcht auch ein trefflicher
Gatte und Familienvater geweſen ſein2 Bolle 37 Jahre ſtand ihni die Kurfürſtin
Anna in Liebe und Treue zur Seite; ja, in dieſem langen Eheleben war fie nur
wenige Wochen von ihni entfernt. Sie begleitete ihn auf Reiſen zu Reichs- und
Kurfürſtentagen, an auswärtige Höfe, ja ſelbſt auf Jagdzüge. Sie beſuchte an
ſeiner Seite den Landwirt, den Bienenzüchter, den Obſt- und Weinbauer, den
Handwerksmann und den Künſtler. Aufs treulichſte wachte ſie über ihre Kinder,
9 Prinzen und 6 Prin-
zeſſinnen, von denen aber
nur vier die Eltern über-
lebten. In der Kapelle

des Auguſtusburger

Schloſſes wird ein Altar-
bild gezeigt, gemalt von
dem jüngeren Cranach,
welches den ani Kreuz er-
höhten Chriſtus und dar-
nnter zu beiden Seiten
den Kurfürſten niit den
Prinzen und die Kur-
fürſtin mit den Prinzeſ-
ſinnen in betender Hal-
tnng darſtellt.

Anna war das .
ßlttuſter einer Haus-
frau. Auf dem Oſtra-
uortnerke ſtellte ſie die
dtttägde an und hielt auf
Ordnung und Sittſamkeit.
In aller Frühe erſchien ſie täglich in der Gutswirtſchaft, nnterſuchte deu Stall,
prüfte die Molkerei und ordnete den Verkauf für den Markt an. Sie ſchäinte
ſich nlcht, ihre Tafelbutter ſelbſt zu rühren, ihrem Gemahl die feine Wäſche ſelbſt
zu maſchen und zu plätten. Den Schlüſſel zu ihreui eigenen Wäſchevorrat führte
ſie ſtets bei ſich. Sie hielt es niit Luthers Ausſprnch:

„Der Mann inuß ſelber ſein der Knecht,
Will er ini Hauſe ſchaffen recht;

Die Frau inuß ſelber ſein die Mad,

Soll ſie im Hauſe ſchaffen Rat.

Geſinde nininierhiu bedenkt,

Was Nutz und Schad dem Hauſe brengtltt


Mutter Anna.

7*


Und hier Ocropus:


=- Iß -
die Musik und Handarbeit, namentlich das Drechseln. Zu den Schützenfesten der
Bürger reiste er gern. Den Schützengilden verlieh er Böller und Kanonen als Aus-

zeichnung. Überhaupt nahm er an den Freuden und Leiden seiner Landeskinder

gern teil; er und seine Gemahlin ließen sich oft als Taufpaten wählen und stat-

teten Brautleute reichlich aus.


So war er ein trefflicher Landesvater. Sollte er nicht auch ein trefflicher
Gatte und Familienvater gewesen sein? Volle 8? Jahre stand ihm die Kurfüür stin

Anna in Liebe und Treue zur Seite; ja, in diesem langen Eheleben war sie nur

wenige Wochen von ihm entfernt. Sie begleitete ihn auf Reisen zu Reichs- und

Kurfürstentagen, an auswärtige Höfe, ja selbst auf Jagdzüge. Sie besuchte an

seiner Seite den Landwirt, den Bienenzüchter, den Obst- und Weinbauer, den

Handwerksmann und den Künstler. Aufs trenlichste wachte sie über ihre Kinder,

9 Prinzen und G Prin-

zessinnen, von denen aber

nur vier die Eltern über-

lebten. In der Kapelle

des Augustusburger

Schlosses wird ein Altar-

bild gezeigt, gemalt von

dem jüngeren Cranach,

welches den am Krenz er-

höhten Christus und dar-

unter zu beiden Seiten ,


z

?


den Kurfürsten mit den z
Vze = »- =. zF-

fütrstin mit den Prinzes-

sinnen in betender Hal-

tung darstellt.

- ?

. --'


-=- - ?

?

=e..-


=-D

a=FI


Anna war das -
Mägde an und hielt auf
Ordnung und Sittsamkeit.

- R «

- - ? =.

:; --

s?

? -

,. - =-

?F

R?? - - - --=

vorwerke stellte sie die

--S

-''. ? .---

'? e --


! ?? -
Flutter Anna.
-e


«


s- E
It aller Frühe erschien sie täglich in der Gutswirtschaft, untersuchte den Stall,
prüüfte die Molkerei und ordnete den Verkauf für den Markt an. Sie schämte
sich nicht, ihre Tafelbutter selbst zu rühren, ihrem Gemahl die feine Wäsche selbst
z waschen und zu plätten. Den Schlüssel zu ihrem eigenen Wäschevorrat führte
sie stets bei sich.
Sie hielt es mit Luthers Ausspruch:
, Der Mann muß selber sein der Knecht,
Will er im Hause schaffen recht;
Die Frau muß selber sein die Mad,
Soll sie im Hause schaffen Rat.
Gesinde nimmerhin bedenkt,
Was Nutz und Schad dem Hause brengt!

Fazit

Insgesamt ist die Entwicklung von Ocropus vielversprechend. Da allerdings wieder mal der Trainingsmodus geändert wurde, müssen die Daten, die ich für das Training von Tesseract verwende erstmal in die Zeilenbasierte Variante von Ocropus umgewandelt werden. Sicherlich läßt sich die Erkennungsqualität noch steigern. Im Vergleich zu Tesseract fällt auf, daß Ocropus Bilder noch nicht zuverlässig erkennt und vor dem OCR Prozess herausfiltert. Hilfreich ist die Ausgabe von hOCR, da man so leicht Probleme im OCR-Prozess visualisieren und erkennen kann.

Bei Tesseract besteht aber auch noch Hoffnung, da es einen (leider noch nicht dokumentierten) Cube-Trainings-Modus mitbringt, der die Probleme bei der Erkennung von Fraktur, insbesondere die Verwechslung von 'u' mit 'n' und 'f' mit 'ſ' verringern sollte.

Mittwoch, 6. Februar 2013

Scan Postprocessing, eine Notiz


Bei Heise bin ich über die Software Scan Tailor gestolpert. In Kürze folgt hier ein Erfahrungsbericht, ob sich mit der Software die OCR-Ergebnisse meines Projektes »Bunte Bilder aus dem Sachsenlande« signifikant verbessern lassen.

Die Software ermöglicht Dewarping, Deskewing und bietet eine visuelle Kontrolle.

Zur Installation unter Debian reicht es, das Tar-Ball von der Webseite zu laden und mit

tar xfz scantailor-0.9.11.1.tar.gz 

auszupacken.

Mit

cmake -G "Unix Makefiles"
make
sudo checkinstall

läßt sich ScanTailor auf dem Debian System problemlos installieren.

Der Artikel bei Heise bietet noch ein paar mehr Hintergrundinformationen

Mehr demnächst.

Samstag, 15. Dezember 2012

Erkennung von OCR- und Tippfehlern in Textdateien

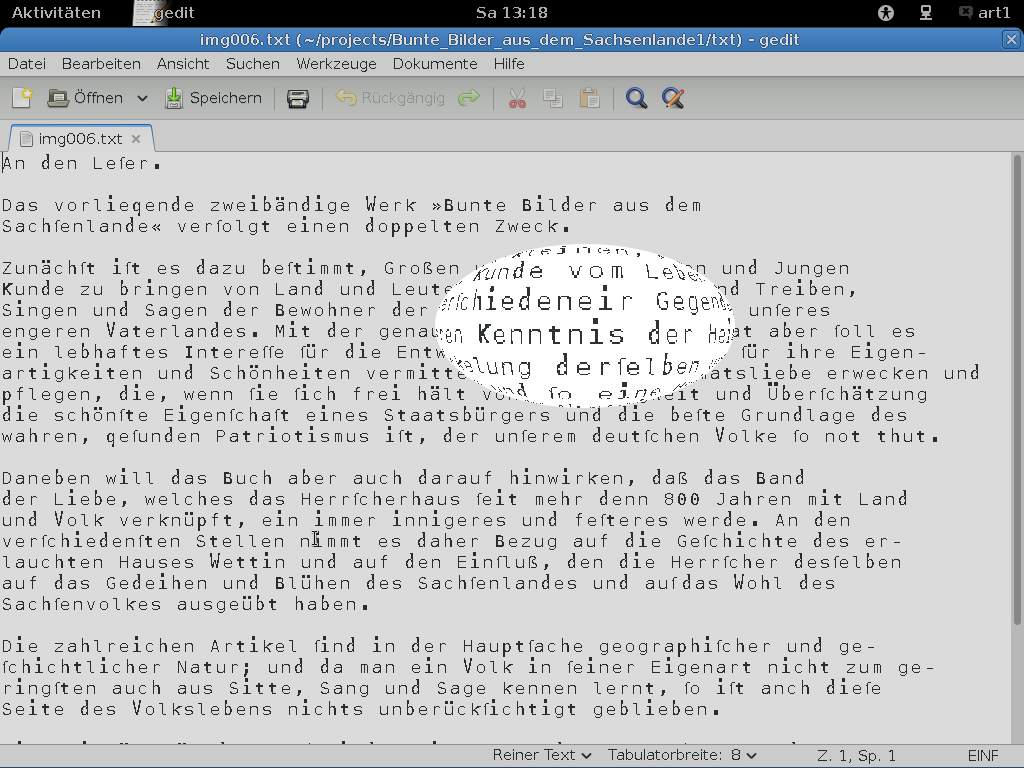
Um Fehler in den Textdateien besser zu erkennen, haben die Distributed Proofreaders, ein internationales Projekt zur verteilten Korrekturlesung gescannter Dokumente, den Zeichensatz DPCustomMono2 entwickelt, der zu verwechselnde Zeichen in besonders prägnanter Weise darstellt.

Hier ein Beispiel der Seite 6 meines Projektes »Bunte Bilder aus dem Sachsenlande«

Einen Vergleich, wie gut DPCustomMono2 Fehler sichtbar macht, kann man auf der Font-Seite der Distributed Proofreaders selber vornehmen.

Donnerstag, 13. Dezember 2012

Teil 6, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"

OCR Verbesserung mit unicharambigs


Mit der Erstellung einer Datei, hier deu-frak.unicharambigs gibt man Tesseract3 Hinweise, welche Zeichen durch welche ersetzt werden können oder sollten.

Hier der Inhalt meiner deu-frak.unicharambigs:

v1
1    B    1    V    0
1    c    1    e    0
1    e    1    c    0
1    f    1    ſ    0
1    ſ    1    f    0
1    V    1    B    0
1    m     2    i n    0
2    ( )    1    0    0
2    - —    1    —    1
2    , ,    1    »    1
2    — -    1    —    1
2    — —    1    —    1
2    1 n    1    m    0
2    - 3    1    s    0
2    - H    1    H    0
2    . H    1    H    0
2    - I    1    s    0
2    i h    2    c h    0
2    i i    1    ä    0
2    i i    1    n    0
2    i i    1    ü    0
2    i n    1    m    0
2    i v    1    w    0
2    l 1    1    U    0
2    l )    1    h    0
2    l l    1    U    0
2    n 1    1    m    0
2    n i    1    m    0
2    n i    1    w    0
2    r i    1    n    0
2    s -    1    s    0
2    t )    1    y    0
2    t i    1    n    0
2    t i    1    ü    0
2    t v    1    w    1
2    z n    2    z u    1
2    m i    2    u n    0
2    m n    2    u m    0
3    1 1 )    1    W    0
3    a n ſ    3    a u f    1
3    ä n ſ    3    ä u ſ    1
3    i i i    1    m    1
3    i i ſ    2    n ſ    1
3    i i ß    2    ü ß    1
3    n i a    2    m a    1
3    n n n    2    m m    0
3    ſ e h    3    ſ c h    0
3    ſ r e    3    f r e    0
3    t m n    3    t u m    0
3    C i n    3    E i n    0
3    i i c    2    ü c    1
3    t n d    3    t u d    1
3    u n n    2    m m    0
3    n n r    3    n u r    1
3    n n d    3    u n d    1
3    b n r    3    b u r    1
3    n u e    3    n n e    1
3    o l ſ    3    o l f    1
3    n m n    3    u n m    0
3    n ſ ſ    3    u f f    0
Die erste Spalte gibt an, wieviel Zeichen aus Original mit wievielen Zeichen ersetzt werden sollen.

Diese Zeile zum Beispiel:

3    i i c    2    ü c    1

gibt Tesseract die Anweisung, Teilstrings "iic" durch "üc" zu ersetzen. 


Erste Ergebnisse


Nach der OCR Erkennung habe ich jetzt im txt-Verzeichnis zu jedem Bild meine Textdateien, die ich nun nach und nach korrigiere. Hier als Ausschnitt die Seite 6 des Buches:
An den Leſer.

Das vorlieqende zweibändige Werk »Bunte Bilder aus dem
Sachſenlande« verſolgt einen doppelten Zweck.

Zunächſt iſt es dazu beſtimmt, Großen und Kleinen, Alten und Jungen
Kunde zu bringen von Land und Leuten, Kunde vom Leben und Treiben,
Singen und Sagen der Bewohner der verſchiedeneir Gegenden unſeres
engeren Vaterlandes. Mit der genaueren Kenntnis der Heimat aber ſoll es
ein lebhaftes Intereſſe ſür die Entwickelung derſelben und ſür ihre Eigen-
artigkeiten und Schönheiten vermitteln und ſo eine Heimatsliebe erwecken und
pflegen, die, wenn ſie ſich frei hält von Engherzigkeit und Überſchätzung
die schönſte Eigenſchaſt eines Staatsbürgers und die beſte Grundlage des
wahren, qeſunden Patriotismus iſt, der unſerem deutſchen Volke ſo not thut.

Daneben will das Buch aber auch darauf hinwirken, daß das Band
der Liebe, welches das Herrſcherhaus ſeit mehr denn 800 Jahren mit Land
und Volk verknüpft, ein immer innigeres und feſteres werde. An den
verſchiedenſten Stellen nimmt es daher Bezug auf die Geſchichte des er-
lauchten Hauses Wettin und auf den Einſluß, den die Herrſcher desſelben
auf das Gedeihen und Blühen des Sachſenlandes und auſ das Wohl des
Sachſenvolkes ausgeübt haben.

Die zahlreichen Artikel ſind in der Hauptſache geographiſcher und ge-
ſchichtlicher Natur; und da man ein Volk in ſeiner Eigenart nicht zum ge-
ringſten auch aus Sitte, Sang und Sage kennen lernt, ſo iſt anch dieſe
Seite des Volkslebens nichts unberückſichtigt geblieben.

Die Beiträge ſür das Buch ſind gelieſert worden von Lehrern und
Freunden der Jugend aus den verſchiedenſten Landesteilen. Einige dieſer
Beiträge erſcheinen im Gewande der Wiſſenſchaftlichkeit und ſind die Frucht
eingehender Quellenſtudien und ſachmänniſcher Einſicht, andere ſind in Form
und Inhalt mehr der Auffaſſungskraft des ſchlichten Mannes angepaßt;
einige ſind mehr belehrend, andere mehr unterhaltend, noch andere ſind

Sonntag, 9. Dezember 2012

Teil 5, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"


Update

Ergänzt um Wörterbucherzeugung und Häufigkeitsliste. Korrektur Fehler OCR-Text (falsche Datei erwischt).

Seitenweises Zeichenerfassen

Wie im letzten Artikel beschrieben, habe ich mir zur Verbesserung der Erkennungsgenauigkeit von Tesseract 3 Paare von TIFF-Dateien und Box-Dateien erzeugt, um die Zuordnung von Blobs zu den Zeichen im UTF-8 Format mit Hilfe von jTessBoxEditor festzulegen.

Ich hatte dazu 5 Seiten aus dem Originalscan ausgewählt, zwei davon aus dem Inhaltsverzeichnis, um auch Ziffern zu erfassen.

Diese Zuordnung hat relativ lange gedauert, da ich pro Seite ca. 2500 Zeichen editieren mußte.

Hartes Training

Das Training von Tesseract besteht aus mehreren Schritten. Wichtig ist die Erzeugung der font_properties Datei, die angibt, daß der Font gebrochen ist, sprich als Frakturschrift daherkommt. Dazu wird folgende Zeile eingetragen:

frak2 0 0 0 0 1

Ebenfalls wichtig sind zwei Dinge, erstens eine Wortliste, die auch Besonderheiten, wie das lange S korrekt enthalten sollte, zweitens ein Häufigkeitsliste, die angibt, welche Wörter, wie häufig vorkommen. Wenn man hier keine Arbeit reinstecken möchte, kann man die Dateien vom deu-frak-Paket verwenden (ist bei Tesseract dabei), die aber keine Unterstützung für langes S beinhaltet.

Mein Weg war daher folgender. Aus den Box-Dateien habe ich die Wörter extrahiert und daraus meine Wortliste gebaut.

Dazu habe ich mit folgendem Aufruf aus allen Box-Dateien die Wörter in eine Textdatei geschrieben und mit Editor in eine Wortliste umgewandelt:

cat deu-frak.frak2.exp*.box | cut -d " " -f 1 | tr -d '\n' > words.txt
Anschliessend die Liste mit sort sortieren und mit uniq die Dubletten entfernen:

cat words.txt | sort | uniq > ogerman

Die Häufigkeitsliste bekommt man mit

cat words.txt |sort -fd  | uniq -c | sort -n -r >  freq
Mit gnumeric noch schnell die beiden Spalten Häufigkeit und Wort vertauschen.

Die Schritte des Trainings habe ich in einem Script zusammengefasst, ein alternatives Script findet sich unter https://github.com/paalberti/tesseract-dan-fraktur/blob/master/deu-frak/buildscript.sh:

#!/bin/bash
rm -f *.tr *.txt deu-frak.inttemp deu-frak.normproto deu-frak.pffmtable deu-frak.shapetable deu-frak.traineddata deu-frak.unicharset pffmtable unicharset
for i in $(seq 0 5); do
tesseract deu-frak.frak2.exp$i.tif deu-frak.frak2.exp$i nobatch box.train
done
unicharset_extractor deu-frak.frak2.exp0.box deu-frak.frak2.exp1.box deu-frak.frak2.exp2.box deu-frak.frak2.exp3.box deu-frak.frak2.exp4.box deu-frak.frak2.exp5.box
#mftraining -F font_properties -U unicharset -O unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr
cat unicharset | sed -e "s/^\([æøåäöüâêàèéçßſ][a-z]*\) 0/\1 3/" \
  -e "s/^\([ÆØÅÄÖÜÂÊÀÈÉÇ][a-z]*\) 0/\1 5/" \
  -e "s/^\([«»„”·§—ɔ–]\) 0/\1 10/" \
  -e "s/^ɔ 3 /ɔ 10 /" \
  -e "s/^½ 0/½ 8/" | sed -e "s/^\([æøåäöüâêàèéçßa-zÆØÅÄÖÜÂÊÀÈÉÇA-Zſ].*\) NULL /\1 Latin /" \
  -e "s/^\([«»„”·§—ɔ–[:punct:][:digit:]].*\) NULL /\1 Common /" \
  -e "s/^\(&c .*\) Common /\1 Latin /" > unicharset.edited
#mftraining -F font_properties -U unicharset -O unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr
shapeclustering -F font_properties -U unicharset.edited deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr
mftraining -F font_properties -U unicharset.edited -O deu-frak.unicharset deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr

cntraining deu-frak.frak2.exp0.tr deu-frak.frak2.exp1.tr deu-frak.frak2.exp2.tr deu-frak.frak2.exp3.tr deu-frak.frak2.exp4.tr deu-frak.frak2.exp5.tr
wordlist2dawg ogerman deu-frak.word-dawg deu-frak.unicharset
wordlist2dawg freq.txt deu-frak.freq-dawg deu-frak.unicharset
mv inttemp deu-frak.inttemp
mv normproto deu-frak.normproto
mv shapetable deu-frak.shapetable
mv pffmtable deu-frak.pffmtable
combine_tessdata deu-frak.
Hat alles funktioniert existiert im Verzeichnis tess_train/ die Datei deu-frak.traineddata, die für das OCR der anderen Seiten interessant ist.

OCR über alle Seiten

Zurück im Hauptverzeichnis, geht es nun ans Eingemachte. Tesseract kann man über die Variable TESSDATA_PREFIX mitteilen, wo es die OCR-Trainingsdaten findet.
Tesseract sucht im angegebenen Verzeichnis nach dem Verzeichnis tessdata/, ich kopiere dazu aus tess_train/ die deu-frak.traineddata.
Um jetzt für alle im Verzeichnis ppm_single/ befindlichen Einzelseiten, eine optische Zeicherkennung zu machen, benutze ich folgenden Aufruf, der im Verzeichnis txt/ die Text-Dateien erzeugt:


export TESSDATA_PREFIX=/tmp/Bunte_Bilder_aus_dem_Sachsenlande/
for i in ppm_single/*.ppm; do echo $i; convert $i /tmp/img.tif; tesseract /tmp/img.tif txt/$(basename $i '.ppm') -l deu-frak; done
Alternativ kann tesseract auch hOCR ausgeben. hOCR ist ein HTML/XML Format, welches im Rahmen von Google Ocropus entwickelt wurde und die Zuordung erkannter Text, Struktur und die zugrundeliegenden Bilder ermöglicht. Es wird mittlerweile von einer großen Anzahl an OCR-Programmen unterstützt. Eventuell erzeuge ich das hOCR mit, um ggf. daraus leichter das EPub-Format zu erzeugen.

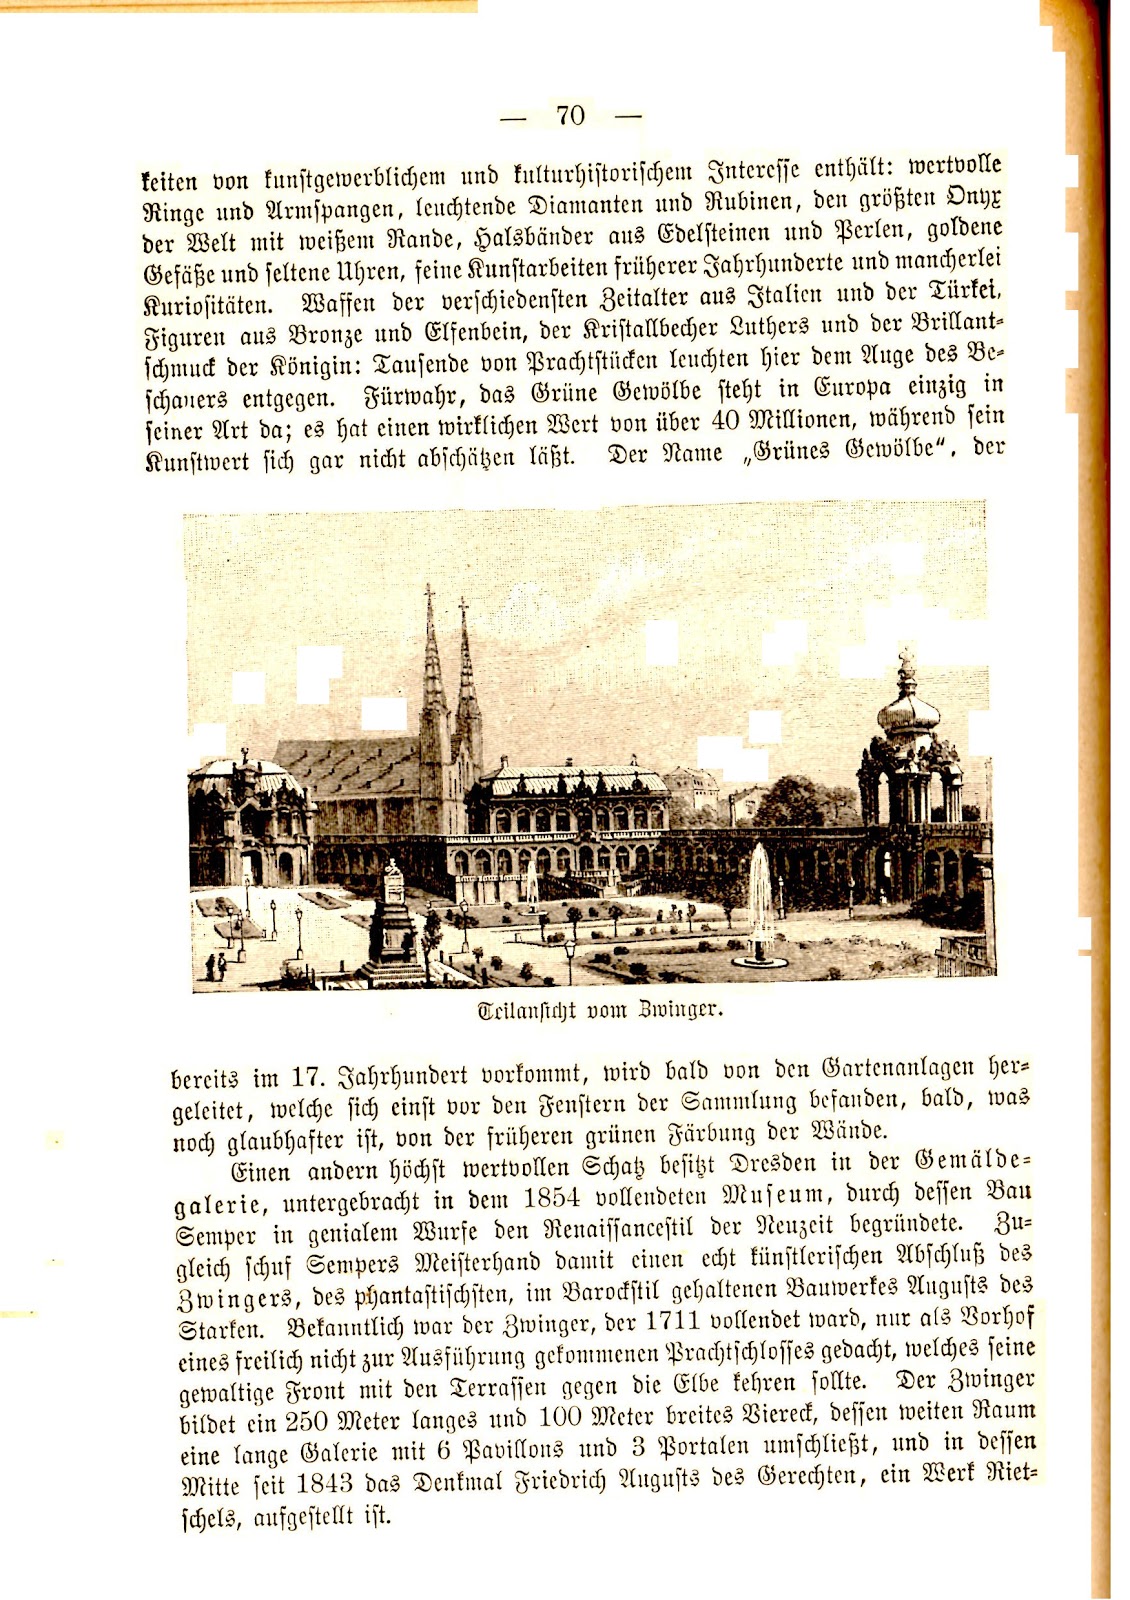
OCR Ergebnis am Beispiel-Text der Seite 70


_.70—

keiten von kunſtgeioerblichem und knltiirhiſtoriſcheiii Jntereſſe enthält: wertvolle
Ringe und Ariuſpangen, lenchtende Dianianten und Rubinen, den größten Onyx
der Welt mit weißeiii Rande, Halsbäiider aus Edelſteinen und Perlen, goldene
Geſäße und ſeltene Uhren, ſeine Knnſtarbeiten früherer Jahrhnnderte und mancherlei
Kurioſitäten. Waffen der verſchiedenſten Zeitalter aus Jtalien und der Türkei,
Figuren aus Bronze und Elſenbein, der Kriſtallbecher Luthers und der Brillant-
ſchinuck der Königin: Tauſende von Prachtſtiicken leuchten hier dem Auge des Ve-
ſchauers entgegen. Fiirwahr, das Grüne Gewöll)e ſteht in Europa einzig in
ſeiner Art da; es hat einen wirklichen Wert von über 40 Millionen, während ſein
Kunſtwert ſich gar nicht abſchätzen läßt. Der Name ,,Griines Gewölbe«, der


bereits im 17. Jahrhundert vorkoniint, wird bald von den Gartenaiilageii her-
geleitet, welche ſich einſt vor den Fenſtern der Samiiiluiig beſanden, bald, was
noch glaubhaſter iſt, von der ſriiheren griinen Färbung der Wände.

Einen andern höchſt wertvollen Schatz beſitzt Dresden in der Gemälde-
galerie, uutergebracht in dem 1854 vollendeten Muſeum, durch deſſen Bau
Semper in genialem Wurſe den Reuaiſſaneeſtil der Neuzeit begri'uidete. Zu-
gleich ſchuſ Seinpers Nieiſterhand damit einen echt künſtleriſchen Abſchliiß des
Zwingers, des pl)antaſtiſchſteii, im Barockſtil gehaltenen Bauwerkes Auguſts des
Starken. Bekaniitlich war der Zwinger, der 1711 vollendet ward, nur als Borhoſ
eines ſreilich nicht zur Ausſiihruiig gekommenen Prachtſchloſſes gedacht, welches ſeine
gewaltige Front mit den Terraſſen gegen die Elbe kehren ſollte. Der Zwinger
bildet ein 250 Meter langes und 1()0 Meter breites Biereck, deſſen weiten Rauin
eine lange Galerie mit 6 Pavillons und 3 Portalen umſchließt, und in deſſen
Mitte ſeit 1843 das Denkmal Friedrich Auguſts des Gerechten, ein Werk Riet-
ſchels, auſgeſtellt iſt.

Donnerstag, 22. November 2012

Teil 4, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"

Warum Tesseract


Jetzt geht es ans Eingemachte. Da das gescannte Buch einen eigenen Font in Fraktur verwendet, ist es notwendig diesen Font zu trainieren um später möglichst wenig Nacharbeit zu haben.

Als OCR-Engine für die Texterkennung nutze ich Tesseract. Im Bereich freier Software sind noch cuneiform und ocropus halbwegs brauchbar. Ersteres kommt mit zuwenig Dokumentation und fällt daher fürs Trainieren der Fonts weg. Letzteres ist schwierig zu kompilieren und die Debian-Variante ist nocch wenig brauchbar.

Tesseract in Version 3 funktioniert ganz gut und ist für den gewünschten Zweck gut genug.

Hartes Training


Um Tesseract zu trainieren folge ich der Anleitung unter http://code.google.com/p/tesseract-ocr/wiki/TrainingTesseract3. Hier nochmal die einzelnen Schritte:

  • mkdir tess_train
  • cd tess_train/
  • convert ../ppm_single/img012.ppm deu-frak2.exp0.tif
  • TESSDATA_PREFIX=./ tesseract -psm 6 -l deu-frak deu-frak.frak2.exp0.tif deu-frak.frak2.exp0 batch.nochop makebox

convert ist Teil von ImageMagick und kopiert die Scanseite ins von tesseract erwartete TIFF-Format.  Anschliessend wird ein box-file erzeugt, welches die Koordinaten der erkannten Symbole enthält.

Mit Hilfe von dem unter http://sourceforge.net/projects/vietocr/files/jTessBoxEditor/ zu findenden jTessBoxEditor weise ich den grafischen Symbolen den korrekten Unicode zu. Korrekt heißt auch, Besonderheiten, wie das lange 'S' zu berücksichtigen.  Dies dauert eine Weile, hier ein Screenshot:

Anschliessend wird tesseract trainiert. Dazu später mehr.

Dienstag, 20. November 2012

Teil2, Selbstversuch Ebook - Befreiung am Beispiel "Bunte Bilder aus dem Sachsenlande"

Kurzausflug Speicherplatz

Wie ich im vorigen Beitrag schrieb, hatte ich aus Platzgründen die Scans als JPEG abgespeichert. Pro Scanseite macht das ca. 1,2 MB. Bei der Konvertierung arbeite ich im folgenden auf Bitmapebene, so das pro Scanseite 25MB anfallen.

Für jedes Zwischenergebnis braucht es also genug Platz.

Gerade drehen

Mein Scanner scannt im A4 Format und die Seiten habe ich als Doppelseiten gescannt, die wie folgt aussehen:


Leider erwartet jeder spätere Verarbeitungsschritt die  Seiten als Doppelseiten, also genau um 90° gedreht.

Hier hilft mir ImageMagick weiter, mit dem ich wie folgt im Verzeichnis ppm/ die neuen Bilder rotiere und gleichzeitig konvertiere. PPM ist ein Bitmapformat (kommt aus der Unix-Ecke). Da zum Beispiel unpaper dieses Format verarbeiten kann, sieht mein Aufruf so aus:
 
for i in *.jpg; do convert $i -rotate 90 ppm/$(basename $i ".jpg").ppm; done

Nun habe ich im Unterverzeichnis die korrekt gedrehten Bilder:


Doppelseiten auftrennen


Leider liegen meine Scans immer noch als Doppelseite vor. Mit unpaper kann ich die Doppelseiten auftrennen. Dazu erzeuge ich zum einen ein neues Verzeichnis ppm_single/ und rufe dann unpaper mit den File-Pattern "img%3d.ppm" auf. %3d gibt hierbei an, daß 3 Ziffern enthalten sind. Die Option "-op 2" splittet mir dann die Doppelseiten auf. Der komplette Aufruf lautet:

unpaper -op 2 ppm/img%03d.ppm ppm_single/img%03d.ppm

Der ganze Prozess dauert ein Weilchen und ich trinke erstmal 'nen Kaffee.

PS.: unpaper macht eigentlich noch ein paar Sachen mehr, zum Beispiel korrigiert es noch leichte Verdrehungen und entfernt Fliegendreck, lest dazu mal die Doku :)

Erstes PDF erzeugen


Da wir ja ein erstes Ergebnis haben wollen, bauen wir uns schnell die Seiten als PDF zusammen. Dazu wieder mit ImageMagick aus den PPMs ein JPEGs erzeugen:

for i in ppm_single/*.ppm; do convert $i jpg/$(basename $i ".ppm").jpg; done


Jetzt habe wir im Verzeichnis jpg/ alle Seiten als JPEG vorliegen. Diese müssen mit Hilfe von pdfjoin, einem Programm aus der TexLive-Distribution, zusammengefügt werden. Es gibt aber auch andere Möglichkeiten, zum Beispiel mit pdftk.

pdfjoin --outfile bilder_aus_dem_sachsenlande.pdf jpg/*.jpg

Das PDF hat 416 Seiten und ist 238MB groß. Wenn wir statt JPEG pdfjoin mit PNG genutzt hätten, wäre das PDF 1,6GB groß geworden.

Die Seitenaufteilung hat erstmal nur suboptimal funktioniert. Darum kümmern wir uns später nochmal.

DJVu erzeugen

Was ist denn DJVu?

Das ist ein krasses Kompressionsformat, ursprünglich für die Online-Präsentation von Bibliotheks- und Archivdaten entwickelt. Archive.org verwendet djvu für das Millon Book Project Hinter djvu stehen zwei Prinzipien:

  • Trenne Scans in Vorder- und Hintergrundebenen auf
  • Komprimiere jede der Ebenen mit dem bestmöglichen Verfahren

Eine Seite unseres gescanntes Buches besteht zum einen aus vergilbtem Papier, welches den Hintergrund darstellt. Dieser Hintergrund ist durch Farbverläufe, relativ weiche Übergänge und geringe Kontraständerungen gekennzeichnet. Der Hintergrund wird daher mit Wavelets kodiert, ähnlich wie JPEG2000 diese verwendet.

Zum anderen besteht die Seite aus Buchstaben die im Vergleich zur Umgebung einen sehr hohen Kontrast aufweisen. Dort interessiert es niemanden, ob diese innerhalb der Schrift leichte Farbnuancen aufweisen. Und vermutlich kommen auf der Seite auch viele gleiche Buchstaben vor. Diese Informationen werden ausgenutzt und die Buchstaben als Verweis auf eine Tabelle gespeichert.

Kurzum, djvu ist richtig krasses Zeugs und wir bekommen eine gegenüber PDF deutlich kleinere Datei hin. Für weitere Informationen schaut Euch djvulibre an. :)

Gut, gut, wie erzeuge ich das denn?


Auf djvulibre von der obengenannten Webseite (aber auch bei Linux-Distributionen in der Regel dabei) gibt es das Programm pdf2djvu. Ein PDF haben wir schon, und wir können folgenden Aufruf nutzen:

pdf2djvu --lossy -j0 --fg-colors=black --bg-subsample=4 -o bilder_aus_dem_sachsenlande.djvu bilder_aus_dem_sachsenlande.pdf


Alternativ können wir den Online-Konverter nutzen.

So, das war es erstmal, die fertige djvu-Datei  ist 160MB groß.

Demnächst geht es weiter mit der Korrektur der Seitentrennung, der OCR-Verarbeitung und wie wir uns langsam Richtung Ebook vortasten.

Update 2012-11-21


Besser als das Tool pdf2djvu ist djvudigital, weil es einen besseren Algorithmus zum Auftrennen der Bildebenen in Hinter- und Vordergrund benutzt. Leider benötigt djvudigital einen speziell angepassten Ghostscript.

Daher entschied ich mich statt aus dem PDF aus den Einzelseiten ein DJVU zu erzeugen. Dies geht mit dem Programm didjvu wie folgt:


didjvu bundle --output bilder_aus_dem_sachsenlande.djvu ppm_single/img*.ppm


Die erzeugte djvu-Datei ist nur noch 21MB groß, hier der Download-Link: https://www.dropbox.com/s/nzij79ulmuh64m7/bilder_aus_dem_sachsenlande.djvu

Viel Spaß beim Durchblättern, demnächst geht es weiter...